



PythonでXMLパースをマスター:minidomとElementTreeの実践ガイド
XMLとは
XML(eXtensible Markup Language)は、構造化データを効率的に保存・転送するために作られました。システムやアプリケーション間の情報交換に広く用いられています。
PythonにはXMLドキュメントのパースと操作のための堅牢なライブラリがあります。ただし、XMLファイルをパースするには、ドキュメント全体をまずメモリに読み込む必要があります。このチュートリアルでは、Pythonのxml.dom.minidomとxml.etree.ElementTreeモジュールを用いて、XMLファイルの読み取り、検査、変更を行う方法を示します。
このガイドを読み終えると、以下ができるようになります:
minidomでXMLをパース- 新しいXMLノードを作成
ElementTreeでXMLをパース
minidomでのXMLパース
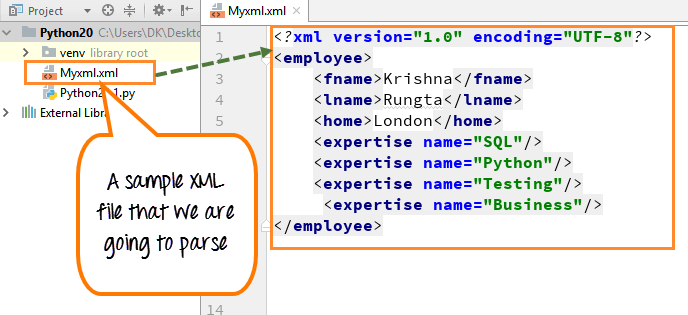
従業員データを含むサンプルXMLファイルから始めます。ファイルは以下のような構造です:
ステップ1) ファイルには従業員の名、姓、自宅、専門分野(SQL、Python、Testing、Business)が列挙されています。
ステップ2) ドキュメント読み込み後、ルート要素のnodeNameと最初の子要素のtagNameを出力。これらはDOMオブジェクトの標準プロパティです。
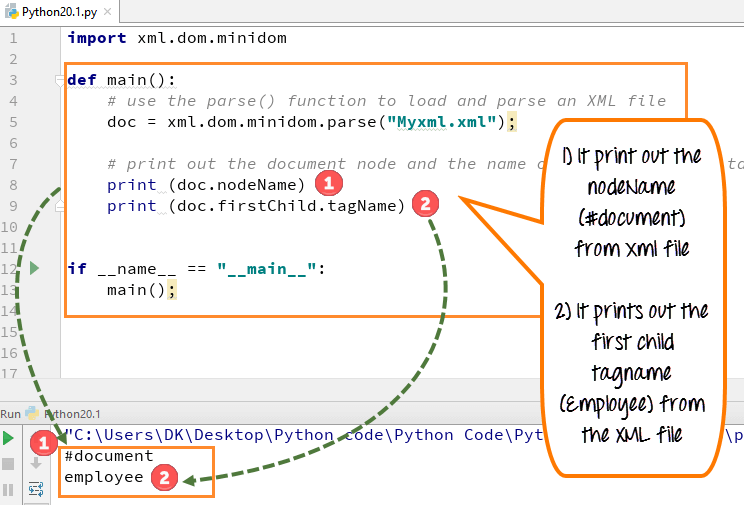
xml.dom.minidomをインポートし、XMLファイル(myxml.xml)を読み込み。parse()でファイルをパースし、ドキュメントオブジェクトを取得。- ドキュメントの
nodeNameと最初の子のtagNameを取得・表示。 getElementsByTagName()で全expertise要素を列挙し、各スキルを出力。
注: nodeNameとtagNameの値はXML DOM命名規則に従うため、XMLに慣れていない場合は unfamiliar に感じるかもしれません。
ステップ3) ドキュメントから全スキルのリストを抽出。以下のコードでスキル名をセットに収集する方法を示します。
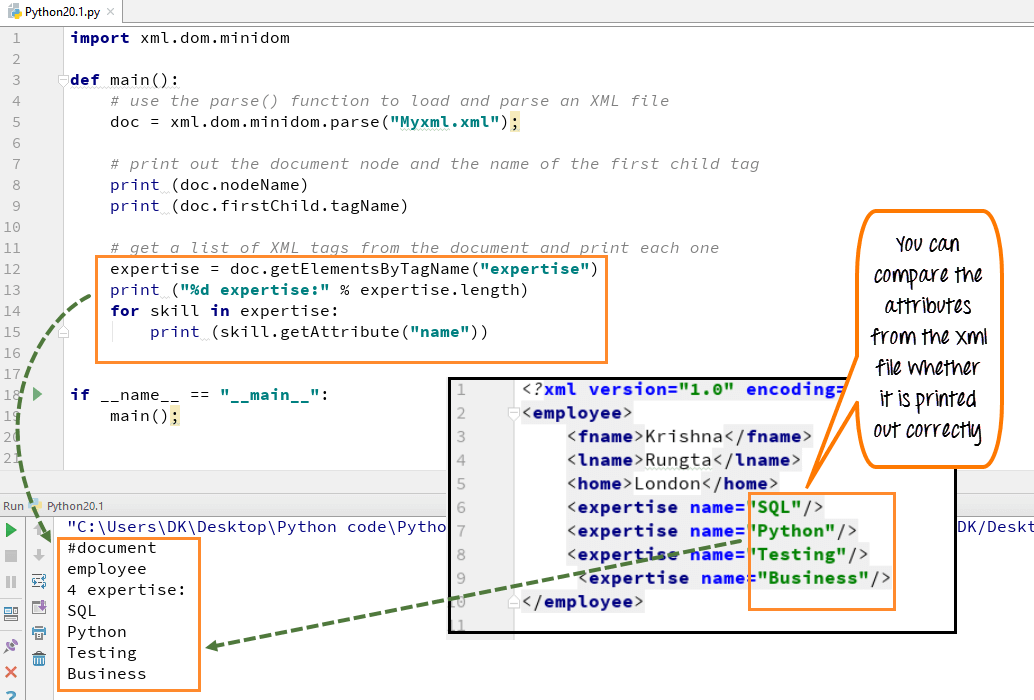
getElementsByTagName("skill")で全スキル要素を取得。- 返されたリストをイテレーションし、各スキルの
name属性を出力。
新しいXMLノードの作成
既存のXML構造に新しいデータを追加するのはminidomで簡単です。例として、expertiseノード「BigData」を追加します。
createElement("expertise")で新しい要素を作成し、name属性を設定。- ドキュメントのルート子要素に新しい要素を追加。
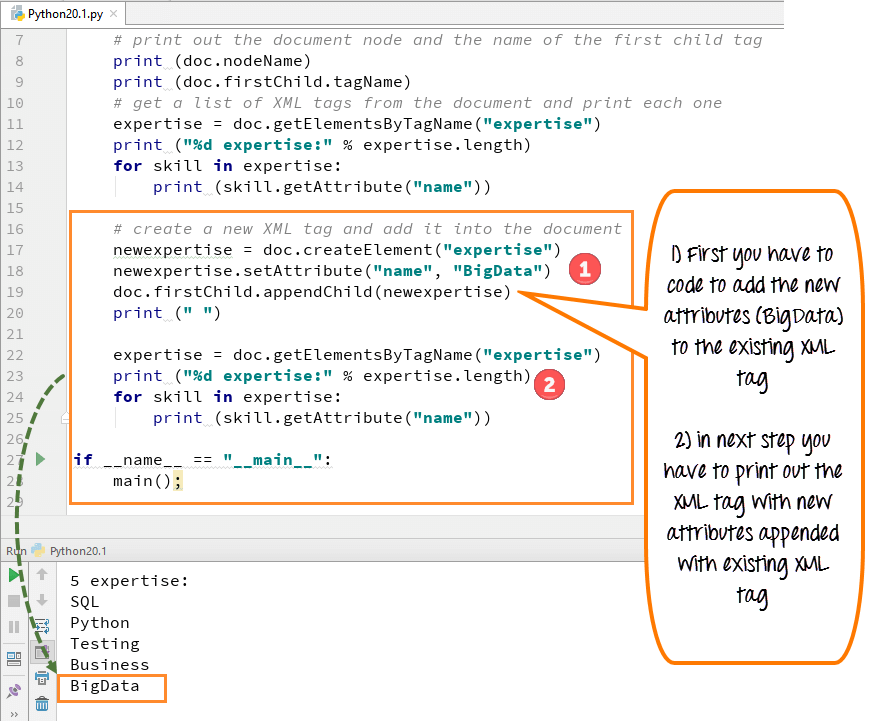
- 挿入後、
expertiseリストに新しい「BigData」スキルが含まれる。
XMLパーサー例
Python 2の例
import xml.dom.minidom
def main():
    # XMLファイルを読み込みパース
    doc = xml.dom.minidom.parse("Myxml.xml")
    # ルート情報を出力
    print doc.nodeName
    print doc.firstChild.tagName
    # 既存のexpertiseエントリを列挙
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
    # 新しいexpertiseエントリを追加
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print " "
    # 追加を検証
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
if __name__ == "__main__":
    main()
Python 3の例
import xml.dom.minidom
def main():
    # XMLファイルを読み込みパース
    doc = xml.dom.minidom.parse("Myxml.xml")
    # ルート情報を出力
    print(doc.nodeName)
    print(doc.firstChild.tagName)
    # 既存のexpertiseエントリを列挙
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
    # 新しいexpertiseエントリを追加
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print(" ")
    # 追加を検証
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
if __name__ == "__main__":
    main()
ElementTreeでのXMLパース
ElementTreeは、XML操作をシンプルかつPythonicにする軽量APIです。フルDOMのオーバーヘッドなしで大規模XMLファイルを読み取るのに適しています。
サンプルXMLデータ:
<data>
  <items>
    <item name="expertise1">SQL</item>
    <item name="expertise2">Python</item>
  </items>
</data>
ElementTreeでのXML読み取り:
まずモジュールをインポート:
import xml.etree.ElementTree as ET
ファイルをパースしルート要素を取得:
tree = ET.parse('items.xml')
root = tree.getroot()
全スキル名を表示する完全なコード:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()
print('Expertise Data:')
for elem in root:
    for subelem in elem:
        print(subelem.text)
出力:
Expertise Data:
SQL
Python
まとめ
Pythonのxml.dom.minidomとxml.etree.ElementTreeモジュールは、開発者がXMLドキュメントを効率的に読み込み、分析、変更できるようにします。minidomは複雑な操作に適したフルDOM表現を提供し、ElementTreeはシンプルなパースと抽出に適した軽量な代替手段です。
parse()でXMLを読み込み(例:doc = xml.dom.minidom.parse(file))。getElementsByTagName()で要素を取得。createElement()とappendChild()で新しいノードを作成・追加。- ElementTreeでは子要素をイテレーションするだけでデータにアクセス可能。
Python
- PythonファイルI/O:ファイル操作、読み書き、管理のマスター
- Python strip()メソッド完全ガイド:実践例付き
- Python len()関数:オブジェクトの長さを測る実践ガイド
- Python yieldをマスター:ジェネレータvs return – 実践ガイド
- Python collections.Counter:効率的なカウント、更新、演算操作
- Python enumerate()をマスター:リスト、タプル、文字列、辞書でインデックス付きループ
- Pythonでファイル・ディレクトリの存在確認:実践ガイド
- Python JSON:エンコード、デコード、ファイル処理の実践ガイド
- Python list.index():要素の位置を検索する実践ガイド
- PythonファイルI/O:入出力操作をマスターする
- Java BufferedReader でファイル読み込み:実践ガイドと例