



オープンソースライブラリがロボットビジョン開発を加速する方法
この記事は、ビジョン誘導ロボットに関するAspenCore特別プロジェクトの一部です。
ロボットビジョンシステムには幅広い機能が求められますが、オープンソースエコシステムはほぼすべての要件に対するソリューションを提供します。基本的な画像処理と物体認識から、高度なモーションプランニングと衝突回避まで、開発者は豊富なライブラリコレクションを活用できます。以下では、高度なロボットアプリケーションを可能にする主要なオープンソース画像処理パッケージを紹介します。 (注:このレポートは基礎的な画像ベースアルゴリズムに焦点を当て、AI駆動ビジョンフレームワークは意図的に除外しています。)
ロボットビジョンソフトウェアの議論では、OpenCVライブラリを認めなければなりません。広く採用され機能豊富なOpenCVは、以下のようなモジュールで2,500以上のアルゴリズムを提供します:
core — すべてのモジュールで共有される基礎的なデータ構造とユーティリティ;
imgproc — 線形/非線形フィルタリング、幾何学的変換、色空間変換、ヒストグラム分析など;
video — 動き推定、背景差分、物体追跡;
calib3d — カメラキャリブレーション、姿勢推定、基本幾何アルゴリズム;
features2d — 特徴検出器、記述子、マッチングルーチン;
objdetect — 定義済み物体クラスとインスタンスの検出。
C++で書かれたOpenCVは、C++、Python、Java、MATLABの言語バインディングを提供し、Windows、Linux、Android、macOSで動作します。またSIMD命令セットをサポートし、CUDA(gpuモジュール)とOpenCL(oclモジュール)によるGPUアクセラレーションを提供します。最近のOpenCV 4.0リリースはパフォーマンス向上と、人気のKinect Fusionアルゴリズムの統合を導入しています。
OpenCVの深さは強みですが、迅速にプロトタイピングしたい開発者にとっては急な学習曲線をもたらすこともあります。PythonベースのSimpleCVライブラリがこのギャップを埋めます。OpenCVの上に構築されたSimpleCVは、経験の浅い開発者でも簡潔なPython呼び出しで一般的なマシンビジョンタスクを実装できる高レベルで直感的なAPIを提供します。例えば、画像閾値処理は1行で実行できます:
from SimpleCV import Image, Color, Display # 半々画像を作成 def halfsies(left, right): result = left crop = right.crop(right.width/2.0, 0, right.width/2.0, right.height) result = result.blit(crop, (left.width/2, 0)) return result # 画像を読み込み img = Image('https://i.imgur.com/lfAeZ4n.png') # 閾値90で二値化し結果を反転 output = img.binarize(90).invert() # 横並び画像を作成 result = halfsies(img, output) # 表示と保存 result.show() result.save('juniperbinary.png')
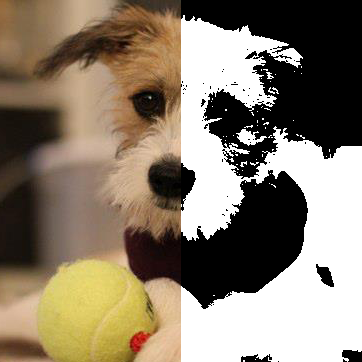
図1. 上記Pythonコードの結果(出典:SimpleCV)
基本的な画像操作を超えて、OpenCVとSimpleCVの両方がロボット認識に不可欠な高度なアルゴリズム(物体認識、アライメント、安全なナビゲーションなど)を提供します。これらのタスクの中心的なデータ構造はポイントクラウド—深度カメラで撮影された物体の多次元表現です。ポイントクラウドは、識別、アライメント、フィッティングなどのコアロボット操作を可能にします。Point Cloud Library (PCL)は、フィルタリング、セグメンテーション、キーポイント抽出などのアルゴリズムを提供し、3D認識に不可欠です。

図2. 基本的なトーラスのポイントクラウドデータセット。(出典:Wikimedia Commons/Kieff)
モノのインターネットテクノロジー