



ディープラーニング vs 機械学習:AIの二大技術の決定的な違いを理解する
コンピューターの黎明期、科学者たちは主に単純な数学的・論理的操作の実行にコンピューターを使用していました。その後、コンピューターは複雑な計算、精巧な問題解決、世界の情報基盤の形成へと徐々に進化しました。従来のコンピューティングの範囲を超えることは、コンピューターに知能が必要であることを意味しました。
研究者とコンピュータエンジニアは、人間の知能を模倣する方向に向かいました。人工知能(AI)は、人間と同等に知能的なコンピューティングシステムの創造に専念するコンピュータサイエンスの分野です。初期のAIモデルは、複雑な論理操作を実行するコンピューティングシステムでした。その後、より賢い、あるいは「知的な」タスクを実行するより高度な技術が開発されました。
AIで最もよく使われる2つの用語が、機械学習とディープラーニングです。この記事では、これら2つの技術の起源、共通点、そして違いを見ていきます。
ディープラーニングと機械学習
機械学習とディープラーニングはAIのサブセットです。両者の間では、ディープラーニングが機械学習のサブセットです。これは、すべてのディープラーニングは機械学習だが、すべての機械学習がディープラーニングではないことを意味します。違いを理解するため、この記事の残りでは「機械学習」という用語からディープラーニングを除外して扱います。
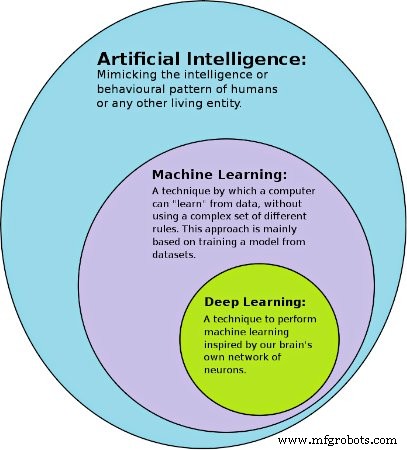
図1. AI、機械学習、ディープラーニングの関係を示すグラフィック。画像提供:Avimanyu786
機械学習
機械学習は、大量のデータを分析して訓練データセットの特徴を理解します。訓練データセットから学んだことを他のデータセットに適用し、「知的な」意思決定を行います。訓練データセットで作成されたモデルは、他の類似データセットで動作し、望ましい出力を生成できます。
機械学習モデルの訓練データセットはラベル付けされている必要があり、開発者は新しいモデルが訓練される過程を監督し、調整しなければなりません。基本的な計算に加え、統計モデルが機械学習モデルの訓練に多用されます。
猫と犬の区別は、人工学習分野で一般的な例です。以下は、機械学習モデルがデータでどのように訓練されるかの概要です。
訓練モデルに、猫と犬の画像を数千枚与えます。それぞれの画像は「猫」または「犬」とラベル付けされています。訓練中のモデルは、猫、犬、その他の物体を区別する画像からの特徴を特定します。これらの特徴は統計的手法を用いて画像から識別されます。十分なデータでモデルが訓練されたら、ラベルなし画像を与えます。訓練済みモデルが、望ましい精度で猫と犬の画像を正しく区別できれば、成功した機械学習モデルと言えます。
ディープラーニング
ディープラーニングは従来の機械学習の進化形です。人間は数千のラベル付き例で学習するのではなく、外部の助けや検証なしに自動的に学習します。ディープラーニングは、機械学習をこの知的学習モデルに一歩近づけます。
ディープラーニングモデルも大量のデータで訓練する必要がありますが、モデルはラベル付きデータで訓練されません。ディープラーニングモデルに与えられるすべてのデータはラベルなしです。モデルはデータからさまざまな要素を識別し、必要な出力を導き出します。
図2. 農業で使用されるニューラルネットワークの視覚的表現。
ディープラーニングモデルは、ニューラルネットワークと呼ばれる複雑な数学的システムを使用してデータから学習します。これらは異なる重みを持つ複数の数学関数層で構成されます。「ディープ(深層)」という用語は、これらの処理層から来ています。
ディープラーニングモデルが猫と犬の区別にどう取り組むか概観しましょう。ニューラルネットワークに、ラベルなしの猫と犬の画像を大量に与えます。ニューラルネットワークは、画像に2種類の動物がいることを自分で理解し、それらをどう区別するかを特定しなければなりません。ラベル付きデータも開発者の監督も不要です。
モデルが正常に訓練されれば、猫と犬のあらゆる画像を区別できます。
機械学習とディープラーニングの比較
以下の表は、機械学習とディープラーニングの違いを簡潔に比較したものです。ディープラーニングは機械学習のサブセットですが、この比較では「機械学習」という用語からディープラーニングを除外して扱います。
機械学習 |
ディープラーニング |
|
訓練データ |
ラベル付きデータ |
ラベルなしデータ |
監督 |
教師あり学習 |
教師なし学習 |
技法 |
主に統計的手法 |
高度な数学関数 |
データ量 |
比較的少ない訓練データで済む |
非常に大量のデータが必要 |
精度 |
相対的に低い精度 |
大量データで高精度 |
訓練時間 |
比較的短い |
非常に長い訓練時間 |
図3. 機械学習とディープラーニングを比較する表。
ディープラーニングの産業応用
機械学習とディープラーニングの両方に産業応用があります。ディープラーニングは機械学習で達成できるすべての用途に使用できます。しかし、ディープラーニングにはより多くの専門知識、はるかに大量のデータ、より高い計算能力、時間が必要です。これらの要因により、両技術の選択には多くの要素の考慮が必要です。
より高い精度が求められる場合、ディープラーニングモデルが望ましいです。しかし、ディープラーニングモデルで高精度を達成するには、非常に大量のデータを処理する必要があり、それにより訓練期間が大幅に長くなります。機械学習アルゴリズムはほとんどのケースで日常的な使用に十分です。
考慮すべきもう一つの一般的な特性は、問題の複雑さです。複雑さが増すにつれて、ディープラーニングモデルの方が機械学習モデルよりうまく機能します。しかし、どこでどの技術を使うべきかという明確なルールはありません。例えば、プラントのエネルギー消費を分析・予測するには機械学習で十分です。しかし、自動品質管理システムを構築するには機械学習では不十分で、ディープラーニングアルゴリズムが必要です。
今日、機械学習は産業界でもディープラーニングよりはるかにアクセスしやすいです。しかし、やがてディープラーニングモデルが改善し、実装コストと参入障壁が下がり、より多くの計算能力がより低価格で利用可能になるでしょう。産業界でのディープラーニング採用は時間とともに増加していくと予想されます。
モノのインターネットテクノロジー