



PLCnextコントローラへの機械学習モデル導入:ONNXとIrisデータセットで学ぶ第一歩
今や誰もが機械学習について耳にし、それがすべてを変えると聞いています。しかし、実際にどう始めればよいか分かっている人はごく少数です。このブログの手順を試すか、あるいは読むだけでも、PLCnextコントローラで機械学習を始める足がかりになれば幸いです。ここでは、最初のMLモデルの訓練、ONNX形式への変換、PLCnextコントローラでの推論実行までを扱います。わかりやすくするため、有名なIrisデータセットを使用してモデルを構築します。
始める前に、何を達成しようとしているかを明確にしておきましょう。このブログで扱うトピックを簡単に説明します。参考資料は文末にまとめています。
機械学習入門
機械学習とは
機械学習の本質は、統計とアルゴリズムを用いてデータセットの中からパターンを見つけ出すことです。大きく分けて3つのタイプがあります:教師あり学習、教師なし学習、強化学習。今日最も広く使われているのは教師あり学習で、このブログでもこれを採用します。教師あり学習では、データにラベルを付け、機械に「探すべきパターン」を明示的に教えます。
教師なし学習ではデータにラベルを付けず、機械自身にパターンを見つけさせます。用途が明確でないため、あまり一般的ではありません。
強化学習では、アルゴリズムが試行錯誤で目的を達成するよう学習します。良い行動には報酬、悪い行動にはペナルティを与えます。GoogleのAlphaGoが有名な例です。
Iris花データセット
Wikipediaによると、Iris花データセットは:
さて、実際にはどのようなデータなのでしょうか?
Irisデータセットには5つのフィールドがあります:がく片の長さ、がく片の幅、花びらの長さ、花びらの幅、そしてIrisの品種。今回の目標は、がく片と花びらの長さ・幅からIrisの品種を分類することです。つまり、モデルを訓練して花の種類を分類させます。このタイプの機械学習は「分類」と呼ばれます。
機械学習はデータセット内の値を予測する「回帰」にも使われ、分類とは異なるアルゴリズムを用います。
アルゴリズム:決定木分類器
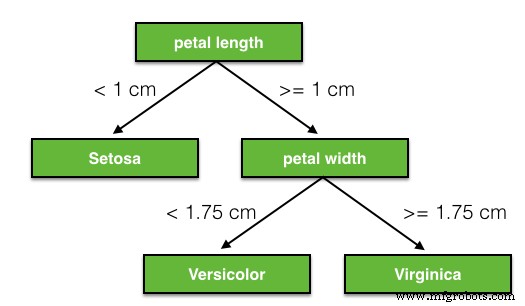
今回は「決定木分類器」を使用します。これが最適だからではなく、直感的で複雑な数学なしに理解しやすいためです。以下にIrisデータセット用の決定木の例を示します。
ONNX(Open Neural Network Exchange)
機械学習モデルは多様なフォーマットで存在し、様々なハードウェアやアクセラレーション手法で動作する必要があります。ONNXはこの問題を緩和するためのオープン標準です。OpenOffice、Azure、世界中の無数のアプリケーションで採用されており、このブログを読んでいるデバイスでもほぼ確実に使用されています。
ONNXモデルを実行するにはONNX Runtimeが必要ですが、特にARMプロセッサでは課題があります。ただし、提供されているDockerイメージを使えば問題なく動作します。
技術ウォークスルー
前提条件
AXC F 2152コントローラ(ファームウェア2021.0 LTS)と、モデル訓練用のUbuntu 20.04 VMを使用します。訓練・推論用スクリプトは提供されていますが、Ubuntu VMのセットアップは本ブログの範囲外です。必要なPythonパッケージのインストール方法については良質な解説が見つかります。使用パッケージはすべてpip3で正しくインストールできるはずです。
PLCnextコントローラ側にはコンテナエンジンが必要です。手順はこちらで解説されています。AXC F 3152でも同様の手順が可能です。Pythonとコンテナの最低限の経験が必要です。
モデルの訓練
このGitHubリポジトリの内容をダウンロードし、必要なパッケージがインストール済みか確認してください。
最初に実行するのは訓練スクリプトで、Irisデータセットにモデルをフィッティングします。以下は訓練スクリプトからのコード抜粋です。このスクリプトは訓練済みモデルを含む「.onnx」ファイルを生成します。
# データセットを訓練用とテスト用に分割
iris = load_iris()
X, y = iris.data, iris.target
X_train, X_test, y_train, Y_test = train_test_split(X, y)

# モデルを定義し、訓練データでフィッティング、モデル情報を出力
clr = DecisionTreeClassifier()
clr.fit(X_train, y_train)
print(clr)

# sklearn形式からONNX(Open Neural Network Exchange)へ変換
initial_type = [('float_input', FloatTensorType([None, 4]))]
onx = convert_sklearn(clr, initial_types=initial_type)
with open("decision_tree_iris.onnx", "wb") as f:
    f.write(onx.SerializeToString())
Ubuntu上での推論確認
開発マシンでモデルを実行して確認します。推論スクリプトを実行すると、Irisの品種に対応する2つの整数が得られるはずです。
import numpy as np
import onnxruntime as rt

X_test = np.array([[5.8,4.0,1.2,0.2],[7.7,3.8,6.7,2.2,]])

sess = rt.InferenceSession("decision_tree_iris.onnx")
input_name = sess.get_inputs()[0].name
label_name = sess.get_outputs()[0].name
pred_onx = sess.run(
    [label_name], {input_name: X_test.astype(np.float32)})[0]
print(pred_onx)

# 出力例: [0 2]
PLCnext上での推論実行
お好みのSFTPクライアントで、「.onnx」ファイルと「inference.py」をPLCnextコントローラの/opt/plcnext/onnxに配置します。root権限で以下のコマンドを実行:
balena-engine run -it --name onnx -v /opt/plcnext/onnx/:/app pxcbe/onnx-runtime-arm32v7Python推論スクリプトを実行:
cd /app
python3 /app/inference.py
Ubuntu VMでの推論と同じ出力が得られれば成功です!おめでとうございます。さあ、世界を変えていきましょう!
アプリケーションへの実装について
実はまだ終わりではありません。Irisの分類は面白いですが、ロジックコントローラでの実用的な応用はすぐには思いつきません。独自のモデルを作り、そのモデル用のAPIを作成して推論できるようにする必要があります。データをOPC UAでモデルに渡すか、カスタムRESTエンドポイントを構築するか、いずれにせよ提供されたコード以上の実装が必要です。
Dockerイメージの構築には文字通り数日と徹夜を要した経験から、提供されているイメージをベースに独自のイメージを構築することを強く推奨します。参考資料にPythonコンテナアプリ構築の良質なリソースへのリンクがあります。
参考資料
- 機械学習とは(フローチャート解説)
- Iris花データセット(Wikipedia)
- Irisデータセットの決定木図
- ONNX公式サイト
- PLCnext Docker入門
- 5分でPythonアプリをコンテナ化
- ONNXモデルリポジトリ
産業技術