



ディープラーニング完全解説:モダンAIの鍵を握る技術
1990年のアーノルド・シュワルツェネッガー主演映画『トータル・リコール』は、2084年、ほぼ1世紀先の未来を描いています。映画によると、未来には自動運転車があります。これは1990年当時はSFでしたが、今や現実です。Apple、Alphabet、Nissan、Uberなど多くの企業が自律走行車に取り組んでいます。Teslaは機能する自動運転車をエンドユーザーに販売しており、うまく機能しているようです。
わずか30年でSFを現実にしたものは何でしょうか? 答えはディープラーニングです。
人工知能からディープラーニングへ
ギリシャ神話の火と金属加工の神ヘファイストスは、黄金のロボットと機械を作りました。1770年代の機械仕掛けのトルコ人(チェス指し自動人形)以来、人間は人間の知能を模倣する装置を開発し続けてきました。機械仕掛けのトルコ人は欺瞞でしたが、後に20世紀後半には人間を倒せるコンピューターが開発されました。これらすべては、人間の脳を模倣できるシステムを作ろうとする努力でした。
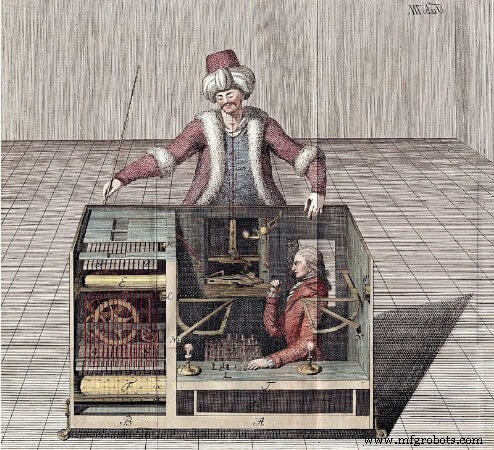
図1. トルコ人の断面図。画像提供:Humboldt University Library
人工知能(AI)は、人間の脳を模倣しようとするあらゆるコンピューティングシステムに与えられる用語です。アラン・チューリングのチューリングマシンは、論理を用いて解に到達する原始的なAIシステムでした。
機械学習(ML)は、モデルを使用してタスクを実行するAIのサブセットです。これらのモデルは大量のデータで訓練されます。1997年に世界チェスチャンピオンのガリー・カスパロフを破ったコンピューター「ディープ・ブルー」はMLの例です。
ディープラーニングはさらにMLのサブセットで、モデルが人間の監督なしでデータから学習します。したがって、ディープラーニングシステムは非構造化データの教師なし学習が可能です。
ディープラーニング:どう機能するか?
ディープラーニングは、ニューロンが情報を伝達・処理する人間の脳の構造に着想を得ています。ディープラーニングで使用される構造は人工ニューラルネットワーク(ANN)と呼ばれます。ANNは人間の監督なしで情報を識別・分類でき、教師なし学習が可能と言われています。これは従来のML(教師あり学習を使用)と比較して、はるかに大量のデータを必要とします。
ANNは入力層から出力層まで複数の層で構成され、データはそれらを通過します。入力層と出力層以外の層は隠れ層と呼ばれます。ANNの最初の層、すなわち入力層はニューロンで構成されます。ANNのニューロンは、人間のニューロンを密接に表す数学関数です。
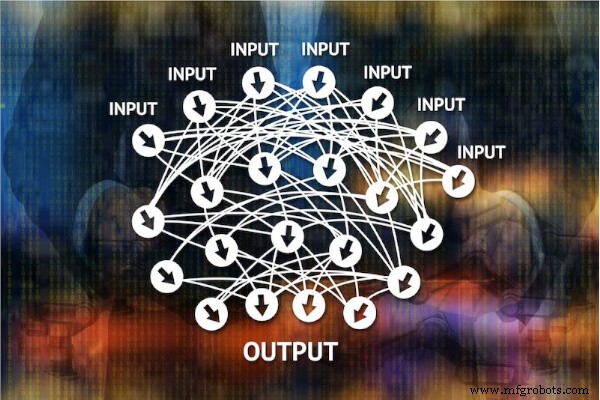
図2. ANNの入力層と出力層の概念。
異なる層間の情報伝達は接続チャネルを通じて行われます。ANNの層のすべてのノードは、これらのチャネルを通じて次の層のすべてのノードと接続されています。各チャネルには値が付いており、これが重みと呼ばれます。したがって、チャネルは重み付きチャネルと呼ばれます。
隠れ層のすべてのニューロンには、バイアスと呼ばれる固有の数値が関連付けられています。情報はチャネルを通じて次の層へ渡り、チャネルに関連付けられた重みを取ります。次の層のニューロンに到達すると、バイアスがチャネルからの重み付き入力の合計に加算されます。
この数学的演算の結果は活性化関数に渡されます。活性化関数は、ニューロンが活性化すべきかどうかを決定します。これは、チャネルからの重み付き和にバイアスを加えた結果に非線形活性化関数を適用することで行われます。活性化関数はニューロンの出力に非線形性を加えます。
活性化関数の適用後に活性化したニューロンのみが、次の層に情報を送れます。これは最終層、すなわち出力層まで続きます。ニューロンのチャネルの重みと隠れ層のバイアスは、よく訓練されたモデルを得るために常に調整され続けます。
最も人気のあるディープラーニングフレームワークには以下があります:
- TensorFlow(Google)
- PyTorch(Facebook)
- Caffe(UC Berkeley)
- Microsoft Cognitive Toolkit
- OpenAI
ディープラーニングのためのデータ
データはディープラーニングの原材料です。理論的には、どんな量のデータもモデルを改善します。しかし、データ収集の労力、必要な訓練時間、モデル訓練に必要な計算能力を考慮すると、ディープラーニングのデータ量は無限にできません。逆に、データが少なすぎると信頼できるディープラーニングモデルは得られません。
ディープラーニングモデルの訓練に必要な最小データ量について、明確なルールはありません。訓練済みモデルの結果に主に依存します。モデルが十分に信頼できない場合、より多くのデータが必要です。ディープラーニングでより一般的なアプリケーションについて、いくつかの経験則があります。
- 回帰分析による予測には最低20データポイント
- コンピュータビジョンによる分類には最低1,000枚の画像
これらはディープラーニングでより一般的な2つのアプリケーションに対するヒューリスティックです。データエンジニアは異なるアプリケーションに対して類似のルールを提唱しています。すべての経験則と同様、これらは完璧ではなく、特定のアプリケーションに応じて変更が必要です。
ディープラーニングの産業応用
ディープラーニングには多くの産業応用があります。いくつか見ていきましょう。
自律走行車両
自動運転車は消費者向けに販売されていますが、産業応用も多数あります。自律走行は工場で使用される搬送デバイスに組み込めます。例えば、自律誘導車(AGV)を完全自律化できます。これにより、こうしたタスクでの肉体労働の必要性がなくなり、安全性と効率が向上します。
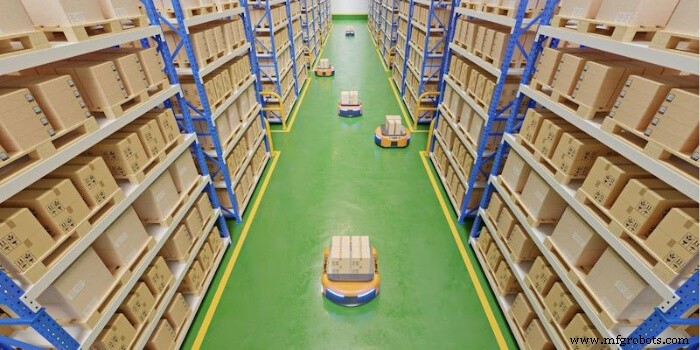
図3. 物流倉庫で使用されるAGV。
コンピュータビジョン
コンピューターは画像から物体を分類・認識します。コンピュータビジョンは自律走行車両の一部になることもありますが、産業応用ではさらに多くの用途があります。コンピュータビジョンで物体の仕分けを自動化できます。コンピュータビジョン支援システムで品質検査を実行できます。プラント敷地と産業プロセスの監視を自動化することもできます。
サプライチェーン管理
企業のサプライチェーンは、複数のベンダー、サプライヤー、地理、規制にまたがる複雑なシステムです。膨大な量の物流を手作業で管理するのは不可能です。ディープラーニングは、IoT(モノのインターネット)デバイスの助けを借りてサプライチェーンで生成される大量データを分析することで、健全なサプライチェーンの維持に役立ちます。
医療応用
ディープラーニングには多くの医療応用もあります。X線、MRIなどの医療画像結果から異常を特定するのに使用できます。装着型モニタリングデバイスで患者の健康を24時間監視できます。薬物発見において、最も確率の高い分子の組み合わせを提示することで支援できます。
ディープラーニングには、航空宇宙、宇宙探査、鉱業、ナビゲーション、防衛システム、サイバーセキュリティなど、さらに多くの産業応用があります。ディープラーニングはあらゆる産業分野で急速に採用され、まもなくインダストリー4.0の不可欠かつ避けて通れない要素になるでしょう。
モノのインターネットテクノロジー
- ディープラーニング:インテリジェントオートメーションで産業を変革
- AI、機械学習、ディープラーニングの違いを徹底解説
- 酸素(O2)センサーを理解する:役割、配置、故障の兆候
- LTE‑M(Cat‑M1):低電力4G IoT接続の未来
- Weightless理解:LPWAN標準の包括的ガイド
- LoRa FAQ:専門家が答える14のよくある質問
- スマート廃棄物管理:IoTが効率化と廃棄物削減を実現する方法
- 「信頼性のインターネット」におけるデータ活用:効果的管理のための戦略
- 医療分野におけるAI・深層学習のアウトソーシング:データプライバシーの保護
- デバイスアテステーション:GlobalPlatformがIoTに信頼を構築する仕組み
- A2工具鋼:産業・木工用途に最適な汎用・高コスパ冷間工具鋼