



ブロックRAMにおける堅牢なVHDLリングバッファFIFOの設計
循環バッファ(リングバッファ)は、シーケンシャルプログラミング言語でキューを実装する際によく用いられる構造ですが、ハードウェアでも実装可能です。本記事では、ブロックRAM上でFIFOを実現するためのリングバッファをVHDLで作成します。
FIFO実装時の設計判断
FIFOを実装する際には多くの設計判断が必要です。どのインターフェースが必要か? リソース制約はあるか? オーバーライトやオーバーリードに対する耐性は必要か? レイテンシは許容されるか? これらはFIFO作成を依頼されたときに浮かぶ代表的な疑問です。
オンラインには多くの無料FIFO実装や、Xilinx LogiCOREのようなFIFOジェネレータが存在します。それでも多くのエンジニアが自前でFIFOを実装したがるのは、基本的なエンキュー/デキュー機能は共通でも、詳細を詰めると大きく異なるからです。
リングバッファの仕組み
リングバッファは、データを格納する連続したメモリ領域を用い、データの移動を最小限に抑えるFIFO実装です。新しい要素は、書き込みから読み出されてFIFOから取り除かれるまで、同じメモリ位置に留まります。
FIFO内のデータ位置と要素数を管理するために2つのカウンタ(ポインタ)を使用します。これらはデータ格納領域の先頭からのオフセットを指し、VHDLでは配列インデックスに相当します。以下ではこれらを「ポインタ」と呼びます。
2つのポインタは「ヘッド(head)」と「テイル(tail)」です。ヘッドは次に書き込まれるデータが格納されるメモリスロットを、テイルは次に読み出される要素を指します。他のバリエーションもありますが、本記事ではこの方式を採用します。
空状態

ヘッドとテイルが同じ要素を指しているとき、FIFOは空です。上図は8スロットのFIFOで、両ポインタが要素0を指しており、初期状態を示しています。どのインデックスで一致していても空状態です。書き込みごとにヘッドが、読み出しごとにテイルが1つ進みます。最大インデックスに達したら次の書き込み/読み出しで最小インデックスに戻ります。これがリングバッファの利点です:データは動かず、ポインタだけが循環します。
ヘッドがテイルをリードしている状態

上図は5回書き込みを行った状態です。テイルはスロット0、ヘッドはスロット5を指しています。データが格納されているスロットは薄青で示されています。テイルが最古の要素、ヘッドが次の空きスロットを指します。ヘッドのインデックスがテイルより大きい場合、要素数はヘッド−テイルで求められます(図では5)。
テイルがヘッドをリードしている状態

ヘッド−テイルの単純な減算はヘッドがリードしているときのみ有効です。図ではヘッド=2、テイル=5なので2−5=−3となり意味を成しません。解決策はヘッドに総スロット数(ここでは8)を加算することです:(2+8)−5=5、正しい要素数が得られます。テイルは常にヘッドを追いかけるため、半分の時間はテイルのインデックスがヘッドより大きくなります。データはその間に格納されます(薄青部分)。
満杯状態

リングバッファが満杯になると、テイルはヘッドの直後のインデックスを指します。この方式では、空と満杯を区別するために少なくとも1スロットを空けておく必要があります。図では使用不能な空きスロットが黄色で示されています。専用の空/満杯フラグを用いれば全スロットをデータ格納に使えますが、レジスタとLUTの追加ロジックが必要です。本実装では「1スロット空ける」方式を採用し、安価なブロックRAMのみを犠牲にします。
リングバッファFIFOの実装
FIFOのインターフェース信号の定義は、実装可能なリングバッファのバリエーションを制限します。ここでは、古典的な読み書きイネーブルと空/満杯/有効インターフェースの変種を採用します。
- 入力側:書き込みデータバス(
wr_data)と書き込みイネーブル(wr_en)。wr_enアサートで入力データをサンプリング。 - 出力側:読み出しデータ(
rd_data)、読み出し有効(rd_valid)はFIFOが制御。読み出しイネーブル(rd_en)は下流モジュールが制御。 - 制御フラグ:
empty、fullはFIFOが制御し、リーダー/ライターに状態を通知。
バックプレッシャー対策
FIFOが空または満杯になってから対応すると、インターフェースロジックが反応する時間がありません。クロックサイクル単位で動作するシーケンシャルロジックでは、クロックの立ち上がりエッジがイベントをタイムステップに分割します。

解決策として、almost emptyとalmost full信号を1クロックサイクル先行させます。これにより、連続読み書き時でも外部ロジックが反応できるようになります。本実装ではこれらをempty_next、full_nextと命名します(接頭辞ではなく接尾辞を好むため)。

エンティティ定義
以下はリングバッファFIFOのエンティティです。ポートの入出力信号に加え、2つのジェネリック定数を持ちます。RAM_WIDTHは入出力ワードのビット幅(各メモリスロットのビット数)、RAM_DEPTHはリングバッファ用に確保するスロット数です。1スロットは満杯検出用に予約されるため、実質容量はRAM_DEPTH - 1となります。RAM_DEPTHはターゲットFPGAのブロックRAM深さに合わせるべきです。未使用のブロックRAM内部は他のロジックと共有できません。
entity ring_buffer is
generic (
  RAM_WIDTH : natural;
  RAM_DEPTH : natural
);
port (
  clk : in std_logic;
  rst : in std_logic;
  -- Write port
  wr_en : in std_logic;
  wr_data : in std_logic_vector(RAM_WIDTH - 1 downto 0);
  -- Read port
  rd_en : in std_logic;
  rd_valid : out std_logic;
  rd_data : out std_logic_vector(RAM_WIDTH - 1 downto 0);
  -- Flags
  empty : out std_logic;
  empty_next : out std_logic;
  full : out std_logic;
  full_next : out std_logic;
  -- The number of elements in the FIFO
  fill_count : out integer range RAM_DEPTH - 1 downto 0
);
end ring_buffer;
クロックとリセットに加え、古典的なデータ/イネーブルの読み書きポートを備えます。rd_validは、rd_enパルスの1クロックサイクル後にアサートされ、rd_dataに有効データが載っていることを示します。この遅延の理由は後で説明します。
empty_nextは残り要素数が1以下でアサート、emptyは0でアサート。full_nextは空きスロットが1以下でアサート、fullは0でアサートします。fill_countは現在格納されている要素数を出力し、内部で使用するためエンティティに露出しています(未接続でも合成時に最適化されます)。
宣言部
VHDLファイルの宣言部では、カスタム型、サブタイプ、内部信号、ポインタインクリメント用プロシージャを宣言します。
architecture rtl of ring_buffer is
  type ram_type is array (0 to RAM_DEPTH - 1) of std_logic_vector(wr_data'range);
  signal ram : ram_type;
  subtype index_type is integer range ram_type'range;
  signal head : index_type;
  signal tail : index_type;
  signal empty_i : std_logic;
  signal full_i : std_logic;
  signal fill_count_i : integer range RAM_DEPTH - 1 downto 0;
  -- Increment and wrap procedure
  procedure incr(signal index : inout index_type) is
  begin
    if index = index_type'high then
      index <= index_type'low;
    else
      index <= index + 1;
    end if;
  end procedure;
begin
ram_typeでRAMをモデル化し、ram信号でデータを保持。index_typeはRAM_DEPTHに依存する整数サブタイプで、ヘッド/テイルポインタに使用。内部用シグナルには_iサフィックスを付与(エンティティポートをinoutにするのは悪習慣とされるため)。incrプロシージャはポインタをインクリメントし、最大値で0にラップします(整数型にはラップ機能がないため)。
並行文
アーキテクチャの冒頭に並行文をまとめます。これらは1行の信号代入であり、見落とされやすいためです。
  -- Copy internal signals to output
  empty <= empty_i;
  full <= full_i;
  fill_count <= fill_count_i;
  -- Set the flags
  empty_i <= '1' when fill_count_i = 0 else '0';
  empty_next <= '1' when fill_count_i <= 1 else '0';
  full_i <= '1' when fill_count_i >= RAM_DEPTH - 1 else '0';
  full_next <= '1' when fill_count_i >= RAM_DEPTH - 2 else '0';
最初のブロックで内部シグナルを出力にコピー(シミュレーション上は1デルタサイクル遅延)。2番目のブロックでフラグを生成:fill_count_iとRAM_DEPTHに基づき、空/満杯および先行信号を決定します。
ヘッドポインタの更新
ヘッドポインタは書き込みイネーブルアサート時にインクリメントします。incrプロシージャを使用します。
  PROC_HEAD : process(clk)
  begin
    if rising_edge(clk) then
      if rst = '1' then
        head <= 0;
      else
        if wr_en = '1' and full_i = '0' then
          incr(head);
        end if;
      end if;
    end if;
  end process;
and full_i = '0'でオーバーライトを防止。これがないと満杯時に書き込むとヘッドがテイルと一致し、FIFOが空に見えてデータを「忘れる」ことになります。full_iでガードすれば、上書きされた値のみ失われます。いずれにせよオーバーライト発生自体が外部の不具合を示します。
テイルポインタの更新
テイルポインタも同様に、読み出しイネーブルでインクリメントし、オーバーリードをand empty_i = '0'で防ぎます。また、有効読み出し時にrd_validをパルス出力します。
  PROC_TAIL : process(clk)
  begin
    if rising_edge(clk) then
      if rst = '1' then
        tail <= 0;
        rd_valid <= '0';
      else
        rd_valid <= '0';
        if rd_en = '1' and empty_i = '0' then
          incr(tail);
          rd_valid <= '1';
        end if;
      end if;
    end if;
  end process;
rd_validはrd_enアサートの次のクロックでアサートされます(FIFOが空でない場合)。この信号は便宜上含めており、未接続なら合成で最適化されます。
ブロックRAMの推論
合成ツールにブロックRAMを推論させるには、リセットなしの同期プロセスで読み書きポートを記述します。毎クロック読み書きし、制御信号でデータの有効性を制御します。
  PROC_RAM : process(clk)
  begin
    if rising_edge(clk) then
      ram(head) <= wr_data;
      rd_data <= ram(tail);
    end if;
  end process;
このプロセスは次回書き込みタイミングを知る必要がありません。ヘッドがインクリメントされれば次のスロットに書き込み、前の値が確定します。
フィルカウントの更新
fill_countは空/満杯フラグ生成に用いられ、ヘッド/テイルポインタに敏感な組み合わせプロセスで更新されます。ポインタはクロック立ち上がりで更新されるため、フィルカウントもクロックエッジ直後に変化します。
  PROC_COUNT : process(head, tail)
  begin
    if head < tail then
      fill_count_i <= head - tail + RAM_DEPTH;
    else
      fill_count_i <= head - tail;
    end if;
  end process;
ヘッド−テイルで要素数を計算。テイルがヘッドより大きい場合はRAM_DEPTHを加算して正しい値を得ます。
完全なVHDLコード
以下がリングバッファFIFOの完全なコードです。ModelSimプロジェクトファイルとテストベンチはフォームから入手可能です。
library ieee;
use ieee.std_logic_1164.all;
entity ring_buffer is
generic (
  RAM_WIDTH : natural;
  RAM_DEPTH : natural
);
port (
  clk : in std_logic;
  rst : in std_logic;
  wr_en : in std_logic;
  wr_data : in std_logic_vector(RAM_WIDTH - 1 downto 0);
  rd_en : in std_logic;
  rd_valid : out std_logic;
  rd_data : out std_logic_vector(RAM_WIDTH - 1 downto 0);
  empty : out std_logic;
  empty_next : out std_logic;
  full : out std_logic;
  full_next : out std_logic;
  fill_count : out integer range RAM_DEPTH - 1 downto 0
);
end ring_buffer;
architecture rtl of ring_buffer is
  type ram_type is array (0 to RAM_DEPTH - 1) of std_logic_vector(wr_data'range);
  signal ram : ram_type;
  subtype index_type is integer range ram_type'range;
  signal head : index_type;
  signal tail : index_type;
  signal empty_i : std_logic;
  signal full_i : std_logic;
  signal fill_count_i : integer range RAM_DEPTH - 1 downto 0;
  procedure incr(signal index : inout index_type) is
  begin
    if index = index_type'high then
      index <= index_type'low;
    else
      index <= index + 1;
    end if;
  end procedure;
begin
  empty <= empty_i;
  full <= full_i;
  fill_count <= fill_count_i;
  empty_i <= '1' when fill_count_i = 0 else '0';
  empty_next <= '1' when fill_count_i <= 1 else '0';
  full_i <= '1' when fill_count_i >= RAM_DEPTH - 1 else '0';
  full_next <= '1' when fill_count_i >= RAM_DEPTH - 2 else '0';
  PROC_HEAD : process(clk)
  begin
    if rising_edge(clk) then
      if rst = '1' then
        head <= 0;
      else
        if wr_en = '1' and full_i = '0' then
          incr(head);
        end if;
      end if;
    end if;
  end process;
  PROC_TAIL : process(clk)
  begin
    if rising_edge(clk) then
      if rst = '1' then
        tail <= 0;
        rd_valid <= '0';
      else
        rd_valid <= '0';
        if rd_en = '1' and empty_i = '0' then
          incr(tail);
          rd_valid <= '1';
        end if;
      end if;
    end if;
  end process;
  PROC_RAM : process(clk)
  begin
    if rising_edge(clk) then
      ram(head) <= wr_data;
      rd_data <= ram(tail);
    end if;
  end process;
  PROC_COUNT : process(head, tail)
  begin
    if head < tail then
      fill_count_i <= head - tail + RAM_DEPTH;
    else
      fill_count_i <= head - tail;
    end if;
  end process;
end architecture;
テストベンチ
FIFOをシンプルなテストベンチでインスタンス化し、動作をデモします。ソースコードとModelSimプロジェクトはフォームからダウンロード可能です。
ジェネリック設定:
- RAM_WIDTH: 16
- RAM_DEPTH: 256
テストベンチはリセット後、順次値(1〜255)を書き込み満杯にし、その後全要素を読み出して空にします。波形ではfill_countをアナログ表示して充填レベルを可視化しています。
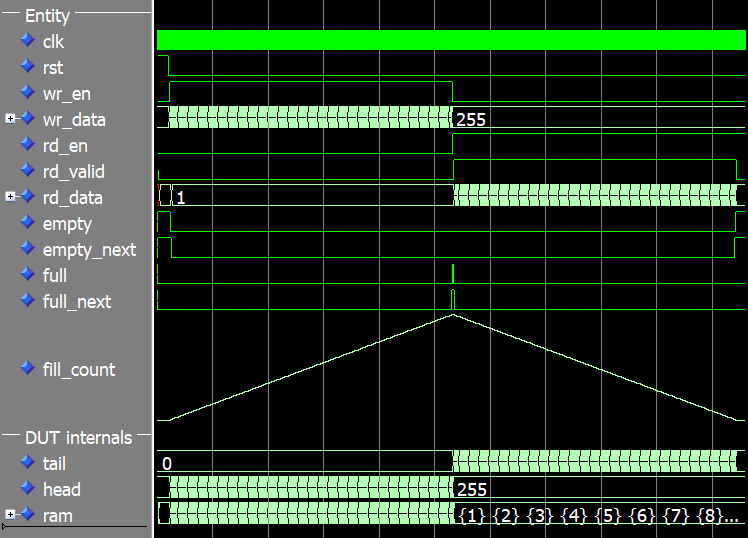
シミュレーション開始時、ヘッド、テイル、フィルカウントは0。fullアサート時にヘッド=255、フィルカウント=255。RAM深さ256でもフィルカウント最大は255(「1スロット空ける」方式のため)。読み出しフェーズではヘッド固定、テイルとフィルカウントが減少。終了時はヘッド=テイル=255、フィルカウント=0。
このテストベンチはデモ用であり、自己検証機能や出力正当性チェックは含まれていません。次回記事では「制約付きランダム検証」を用いたより良いテストベンチを作成します。
Vivadoでの合成
Xilinx Vivadoで合成しました(最も一般的なFPGA実装ツール)。デュアルポートブロックRAMを持つ全FPGAアーキテクチャで動作するはずです。
スタンドアロンモジュールとして実装するにはジェネリックに値を割り当てます。VivadoではSettings → General → Generics/Parametersで設定。
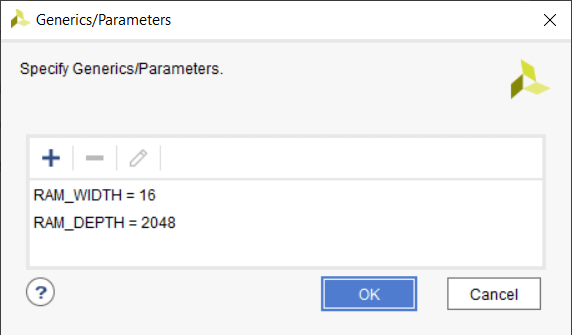
RAM_WIDTH=16(シミュレーションと同一)、RAM_DEPTH=2048(ZynqのRAMB36E1プリミティブ最大深さ)。より小さい値でも同一ブロックRAM数、大きい値なら複数ブロックRAMを消費。
実装後のリソース使用レポート:
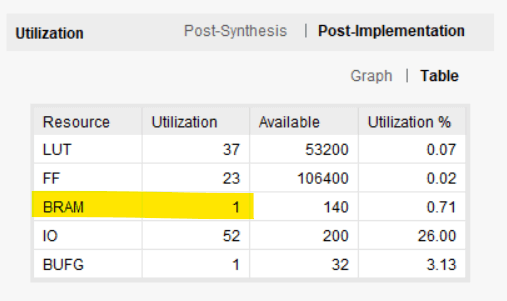
ブロックRAM 1個、少数のLUTとフリップフロップを消費しています。
valid信号の要否
rd_enとrd_validの間に1クロック遅延があるのは必要か? データはrd_enアサート時にrd_dataに既に出ているのでは? この値を使い、読み出し時に次の要素へスキップできないか?

厳密にはvalid信号は不要です。便宜上含めただけです。重要なのはrd_enアサートの次のクロックサイクルまで待つこと:そうでなければRAMが反応する時間がありません。
FPGAのブロックRAMは完全同期コンポーネントで、読み書き両方にクロックエッジが必要です(読み書きクロックは別ソースでも可)。さらに、RAM出力と次のレジスタ間にロジックを置けません。ブロックRAMプリミティブ内部に出力レジスタがあるためです。

上図はwr_data入力からRAMを経てrd_data出力に値が伝わるタイミングです。各信号が立ち上がりエッジでサンプリングされるため、書き込みポート駆動開始から読み出しポート出現まで3クロック、受信モジュールが利用可能になるまでさらに1クロックかかります。
レイテンシ削減の試み
この問題を緩和する方法はありますが、FPGAリソース増大の代償を伴います。読み出しポートから1クロック遅延を削減する実験として、rd_data出力を同期プロセスからramとtailに敏感な組み合わせプロセスに変更します。
PROC_READ : process(ram, tail)
begin
  rd_data <= ram(tail);
end process;
残念ながらこのコードはブロックRAMにマッピングできません。RAM出力と最初の下流レジスタ間に組み合わせロジックが入る可能性があるためです。VivadoレポートではブロックRAMがLUTRAM(LUTベースの分散RAM)に置き換わり、LUT使用量が37から947に急増。ルックアップテーブルとフリップフロップはブロックRAMより高コストです。
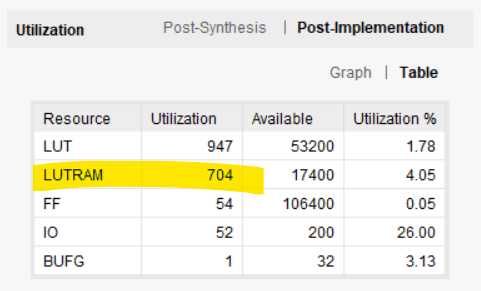
リングバッファFIFOをブロックRAMで実装する方法は多数あります。他の設計で1クロック削減できるかもしれませんが、追加サポートロジックのコストがかかります。ほとんどの用途では本記事のリングバッファで十分です。
更新:
AXI ready/validハンドシェイクを用いたブロックRAMリングバッファFIFOの作成方法
次回ブログ記事では、制約付きランダム検証を用いてリングバッファモジュールのより良いテストベンチを作成します。
続きを読む:
制約付きランダム検証
VHDL
- VHDLで文字列リストを作成する: ベスト・プラクティスと実装例
- Tcl駆動テストベンチでVHDLコード・ロック・モジュールを検証する
- VHDLテストベンチ・シミュレーションを優雅に終了させる方法
- VHDLでPWMコントローラを実装: 設計、シミュレーション、FPGAデモ
- VHDLで乱数生成: 一様分布からOSVVMまで
- VHDLで自己検証テストベンチを構築する実践ガイド
- VHDLで保護型とアクセスポインタを用いた動的リンクリスト実装
- プロセス内プロシージャでVHDLステートマシンをクリーンに設計
- VHDLにおける不純関数の活用:FSMの可読性と保守性向上
- VHDL関数マスター:効率的な設計のための実践ガイド
- VHDLで有限ステートマシンを設計:信号機の実践例