



高度な信号処理がシームレスな音声アシスタントインタラクションを実現する仕組み
スマートスピーカーと音声制御デバイスが急速に普及し、AmazonのAlexaやGoogle Assistantなどのアシスタントが、アップデートごとに私たちの話し言葉を解読する能力を向上させています。
このインターフェースの最大の魅力の1つは、その手軽さです——学習曲線なし、自然な会話だけ。そのスムーズな体験の裏には、生の音声を明確で実行可能なリクエストに変換する洗練された信号処理ステップの連鎖があります。
この記事では、音声制御ソリューションを支えるアーキテクチャを検証し、それらに命を吹き込むハードウェアとソフトウェアの隠れたレイヤーを明らかにします。
信号フローとアーキテクチャ
製品によって詳細は異なりますが、基本フローは一貫しています。AmazonのEchoのようなスマートスピーカーを例に、主要サブシステムを図1に示します。
click for larger image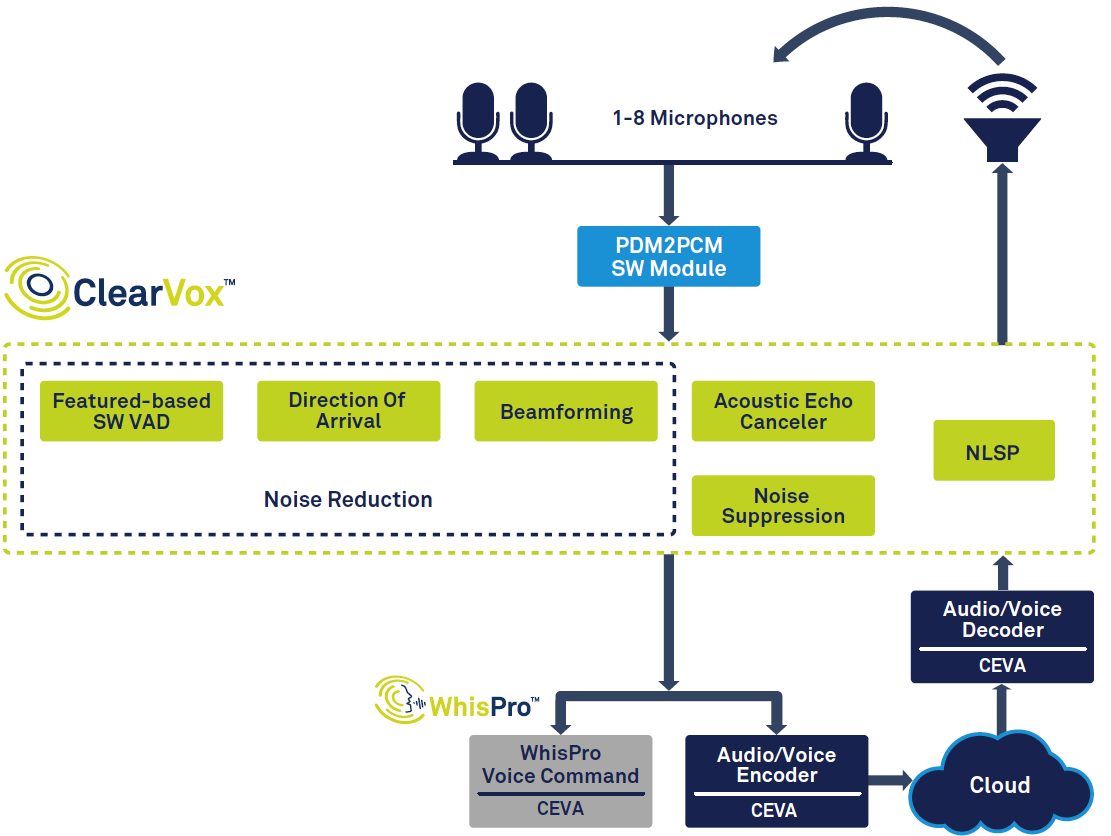
図1: CEVAのClearVoxとWhisProに基づく音声アシスタントの信号チェーン(出典:CEVA)
チェーンは音声活動検出(VAD)から始まり、話し言葉セグメントを分離します。取得した音声はデジタル化され、ユーザーの到来方向に焦点を当てて明瞭度を高める一連のフロントエンドアルゴリズムにかけられます。処理された信号はバックエンド音声処理に転送され、デバイス上(エッジ)とクラウドで部分的に実行される場合があります。最後に、応答(テキストまたは音声)が合成、デコードされ、スピーカーのデジタル-アナログ経路を通じて出力されます。
ユースケースによって変化が生じます。例えば、車載音声インターフェースはロードノイズに対処しなければならず、新興ウェアラブルは超低消費電力と最小コストを要求します。
フロントエンド信号処理
VADとデジタル化後、デバイスは不要な音を抑制しなければなりません。音響エコーキャンセレーション(AEC)はデバイス自体の再生による反射を除去し、音楽再生中でもシームレスな「割り込み」を可能にします。ノイズ抑制が残留バックグラウンドヒスを除去します。
音声制御デバイスは2つのカテゴリに分類されます:ニアフィールド(ヘッドセット、イヤホン)とファーフィールド(スマートスピーカー、テレビ)。ニアフィールドユニットは通常1〜2個のマイクを使用し、ファーフィールドユニットは3〜8個のマイクを展開します。後者はより厳しい音響環境に直面します——声は距離とともに減衰し、バックグラウンドノイズは一定で、残響が信号抽出を複雑にします。
ファーフィールドユニットはビームフォーミングを採用します。マイク間の時間差から音源方向を計算する技術です。これにより、システムはユーザーに焦点を当て、反射を無視し、動きを追跡し、複数の声が存在する場合に単一話者を分離できます。
トリガーワード検出(例:「Alexa」)は重要な機能です。常時リスニングはプライバシー懸念を引き起こすため、多くのシステムはウェイクワード認識をローカルで実行し、完全なコマンド検出後にのみ音声をクラウドに送信します。
クリーンアップされた音声サンプルはエンコードされ、クラウドバックエンドに送信されてより深い分析を受けます。
特化ソリューション
フロントエンド処理は高速、正確、省電力でなければなりません——特にバッテリー駆動ウェアラブルでは。汎用DSPやCPUは、コスト、サイズ、エネルギー消費の観点からこれらの要求を満たすのに苦労します。解決策は、オーディオタスク向けに設計されたアプリケーション特化型DSPです。
CEVAのClearVoxは、多様な音響シナリオでマルチマイクビームフォーミング、到来方向推定、ノイズ抑制、AECを処理するソフトウェアスイートです。CEVAサウンドDSP向けに最適化され、高品質音声取得への低コスト・低消費電力パスを提供します。
トリガーワード検出はCEVAのWhisProが担当します。CEVA DSP専用のニューラルネットワークベースの認識器です。WhisProはウェイクワード検出までメインプロセッサーをスリープさせ、>95%の認識率を維持しながら全体システム電力を大幅に削減します。複数のトリガーフレーズとカスタムワードをサポートし、これは顧客満足度の重要な要素です。
click for larger image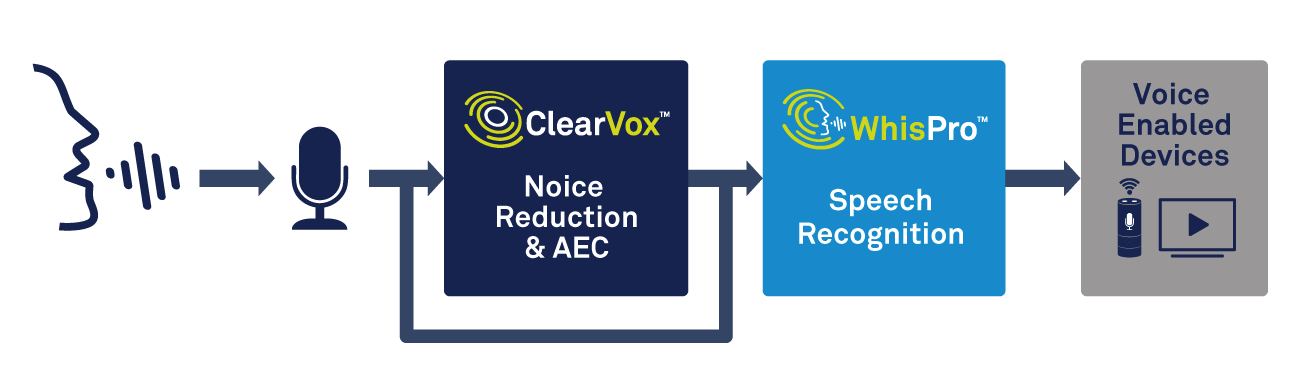
図2: 音声処理と音声認識を用いた音声アクティベーション(出典:CEVA)
音声認識:ローカルかクラウドか
音声がクリーンアップされデジタル化されると、次のステップは自動音声認識(ASR)です。範囲はシンプルなキーワードスポッティングから本格的な自然言語処理(NLP)まで広がります。キーワード検出は狭いスコープのデバイス(スマートサーモスタットなど)に最適で、オフラインでの即時応答を可能にします。
逆に、多くのアプリケーションは文脈理解を必要とします。「街の中心部近くのコスパの良いホテルを表示して」のようなリクエストは、意図、エンティティ、フォローアップ文脈を解析する必要があります——通常、ローエッジチップの能力をはるかに超えるニューラルネットワーク推論を要求します。
クラウドベース処理は、洗練されたNLPを提供する計算力を提供しますが、レイテンシとインターネット接続依存のコストがあります。エッジソリューションも改善しています。CEVAのNeuPro AIプロセッサーがエッジへのオンデバイスニューラルネットワーク推論をもたらし、必要に応じてクラウドにフォールバックしながら、よりスマートで高速なローカル応答を可能にします。
エッジとクラウドの選択にはトレードオフがあります。ローカル処理は速度とプライバシーに優れますが、複雑なクエリに苦戦します。クラウド処理は複雑なNLPにスケールしますが、レイテンシと接続依存を導入します。
結論
音声インターフェースは日常テクノロジーの基盤になりつつあります。信号処理、ASR、AIの継続的進歩——特化ハードウェアと相まって——がより高い精度、より低い消費電力、より低いコストを推進しています。
ClearVox、WhisPro、NeuProのような目的特化ソリューションを採用するOEMは、厳格な性能、コスト、電力目標を満たしながら市場投入までの時間を短縮できます。
音声テクノロジーが成熟するにつれ、さらに自然なインタラクションとより広いアプリケーション地平が期待できます——デバイスとの関わり方を再構築するエキサイティングな旅です。
埋め込み
- 包括的安全プログラムを機能させる実証済み戦略
- ArduinoとProcessingで作るリアルタイムデジタルコンパス
- SCADAシステムの仕組み:産業プロセスの監視と制御
- サプライチェーンをレジリエンスと効率の両立へ今すぐ最適化する
- 勝利するプロトタイプ構築:ラピッド製品開発ステップバイステップガイド
- キャスターの仕組み:初期設計からオムニディレクショナル革新まで
- エアドライヤーの仕組み:圧縮空気を清潔かつ効率的に保つ
- 電気ブレーキの理解:動作原理と重要性
- エッジAIとマイク技術の進化が音声アシスタント普及を加速
- インクジェット印刷グラフェン:3Dプリントエレクトロニクスの未来
- ガラス繊維製造の完全ガイド