



アナログインメモリコンピューティング:省電力エッジAI推論
機械学習とディープラーニングは今や日常テクノロジーに織り込まれています。自然言語アシスタントからリアルタイム物体検出まで、AIは増え続けるコンシューマーおよび産業デバイスを駆動しています。しかし、これらのアプリケーションの多くはクラウドベースの推論エンジンに依存しています——プライバシー、消費電力、レイテンシ、コストに関する懸念を引き起こすアーキテクチャです。
AIをエッジでローカルに展開すれば、これらの問題を解消できます。主なハードルは、従来のデジタルニューラルネットワークアクセラレーターのメモリ駆動型電力消費です。重みと活性化がDRAMやSRAMからフェッチされるとき、データ移動だけで算術演算自体の2〜3桁多くのエネルギーを消費します。アナログインメモリコンピューティングは、不揮発性メモリアレイ内部で乗算累積(MAC)演算を直接実行することで、このボトルネックに取り組みます。
クラウドベースAI:痛みのポイント
エッジデバイスが生データをリモートサーバーに転送すると、いくつかの問題が生じます:
- プライバシーとセキュリティ——個人または機密情報がデータセンターで送信・保存される
- 不要な電力使用——無線で送信されるすべてのビット、クラウドに保存され再取得されるすべてのビットがエネルギーを消費
- 小バッチ推論のレイテンシ——応答に100ms以上かかることがあり、ユーザーに知覚される
- データエコノミーの非効率——センサーが大量のストリームを生成;すべてをアップロードするのは経済的でも持続可能でもない
これらの課題を克服するため、高性能プラットフォーム(クラウド、GPUファームなど)でモデルを訓練し、その結果得られた重みを軽量推論エンジンにマッピングしてローカルで計算を実行します。
ニューラルネットワークのMAC集約的性質
軽量モデルでさえMACが支配的です。例えば、224×224入力のMobileNet-v1は420万パラメータを含み、推論あたり5億6900万MACを必要とします。乗算と累積は密な行列-ベクトル積で実行されます。
なぜデジタルコンピューティングが苦戦するのか
従来のアクセラレーターでは、重みと活性化がDRAM/SRAMに格納され、算術論理ユニット(ALU)にフェッチされる必要があります。図3はメモリボトルネックを示します:データ移動にかかるエネルギー(転送あたり50〜100pJ)が、MAC演算あたり250fJを圧倒します。積極的なデータ再利用技術を用いても、フォンノイマンアーキテクチャは電力効率にハードな限界を課します。
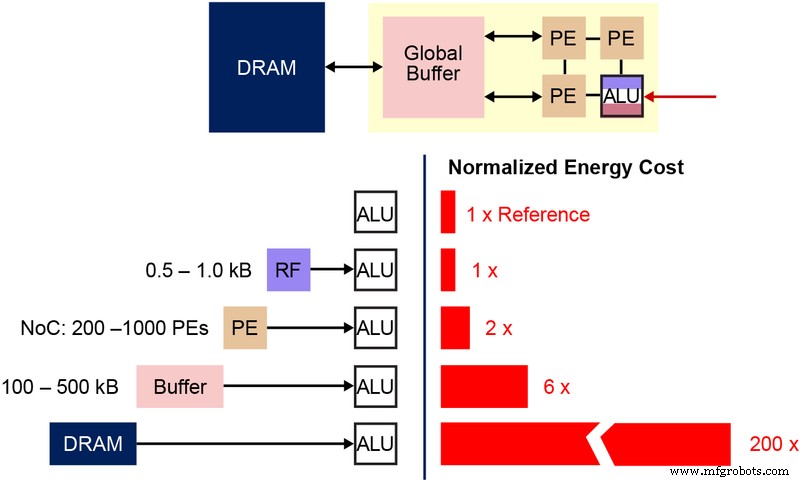 図3: 機械学習計算におけるメモリボトルネック(出典:Y.-H. Chen, J. Emer, and V. Sze, "Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks," ISCA, 2016.)
アナログインメモリコンピューティングの救世主
計算をメモリアレイ自体に埋め込むことで、重みのシャトルの必要性が消滅します。残りのデータ転送は入力信号(通常はセンサー出力)に限定されます。サブスレッショルド領域で動作するフラッシュセルはサブナノアンペア電流を消費し、アクティブ電力を無視できるレベルにします。スタンバイ時、不揮発性セルは電力消費なしでデータを保持します。
Silicon Storage Technology(Microchip傘下)のmemBrain™プラットフォームがこのアプローチを例証します。SuperFlash®(ESF3)メモリテクノロジー上に構築され、各ビットセルを正確な閾値電圧(Vt)にプログラミングでき、重みを表すコンダクタンスを確立します。入力電圧を印加すると、セルを流れる電流が入力と格納された重みの積に等しくなります。
マルチレベルメモリアーキテクチャ
図4はESF3ビットセルの断面を示します。セルは5つの端子——Control Gate(CG)、Word Line(WL)、Erase Gate(EG)、Source Line(SL)、Bitline(BL)——を含みます。高電圧EGがフローティングゲートをプログラミングし、他の端子への低電圧バイアスでセルを読み書きします。
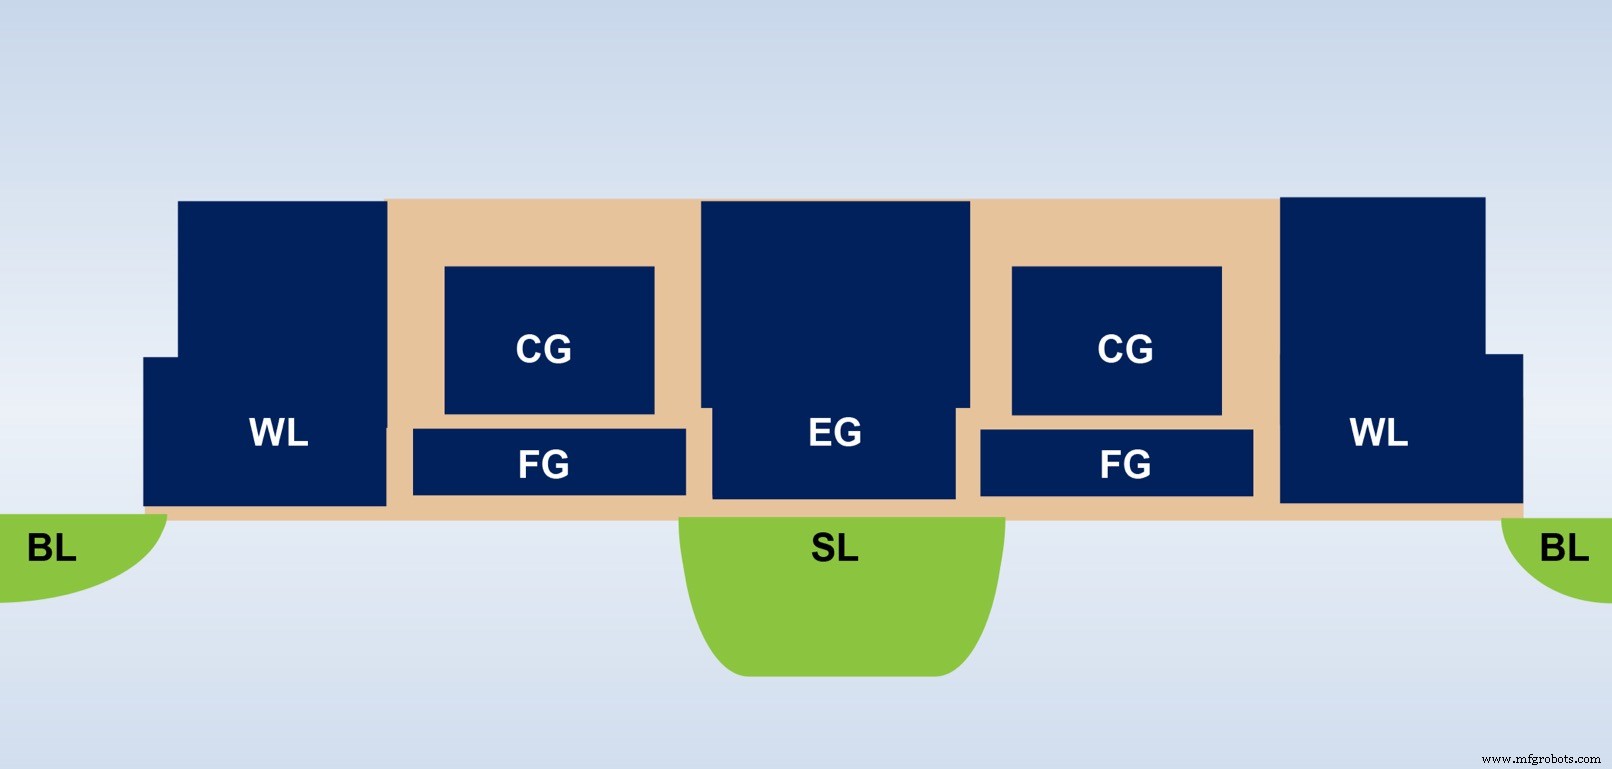 図4: SuperFlash ESF3セル(出典:Microchip Technology)
きめ細かなプログラミングでフローティングゲートVtを調整し、特定のI-V曲線を生成します。図5は、固定CG電圧印加時に4つの異なるVtレベルが4つの別個の電流応答を生む2ビット例を示します。
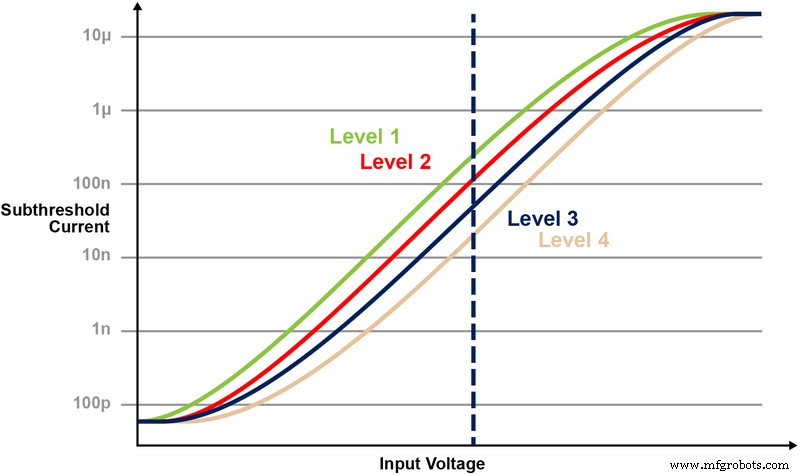 図5: ESF3セルでのVtレベルプログラミング(出典:Microchip Technology)
メモリアレイでのMAC
各セルのコンダクタンスgmが訓練済み重みを体現します。電流Iout = gm · Vinが乗算ステップを実装します。多くのセルを並列に配線することで、列電流が自然に合計され、累積演算が得られます。図6は2×2アレイで2つのMACと1つの累積を実行する様子を視覚化しています。
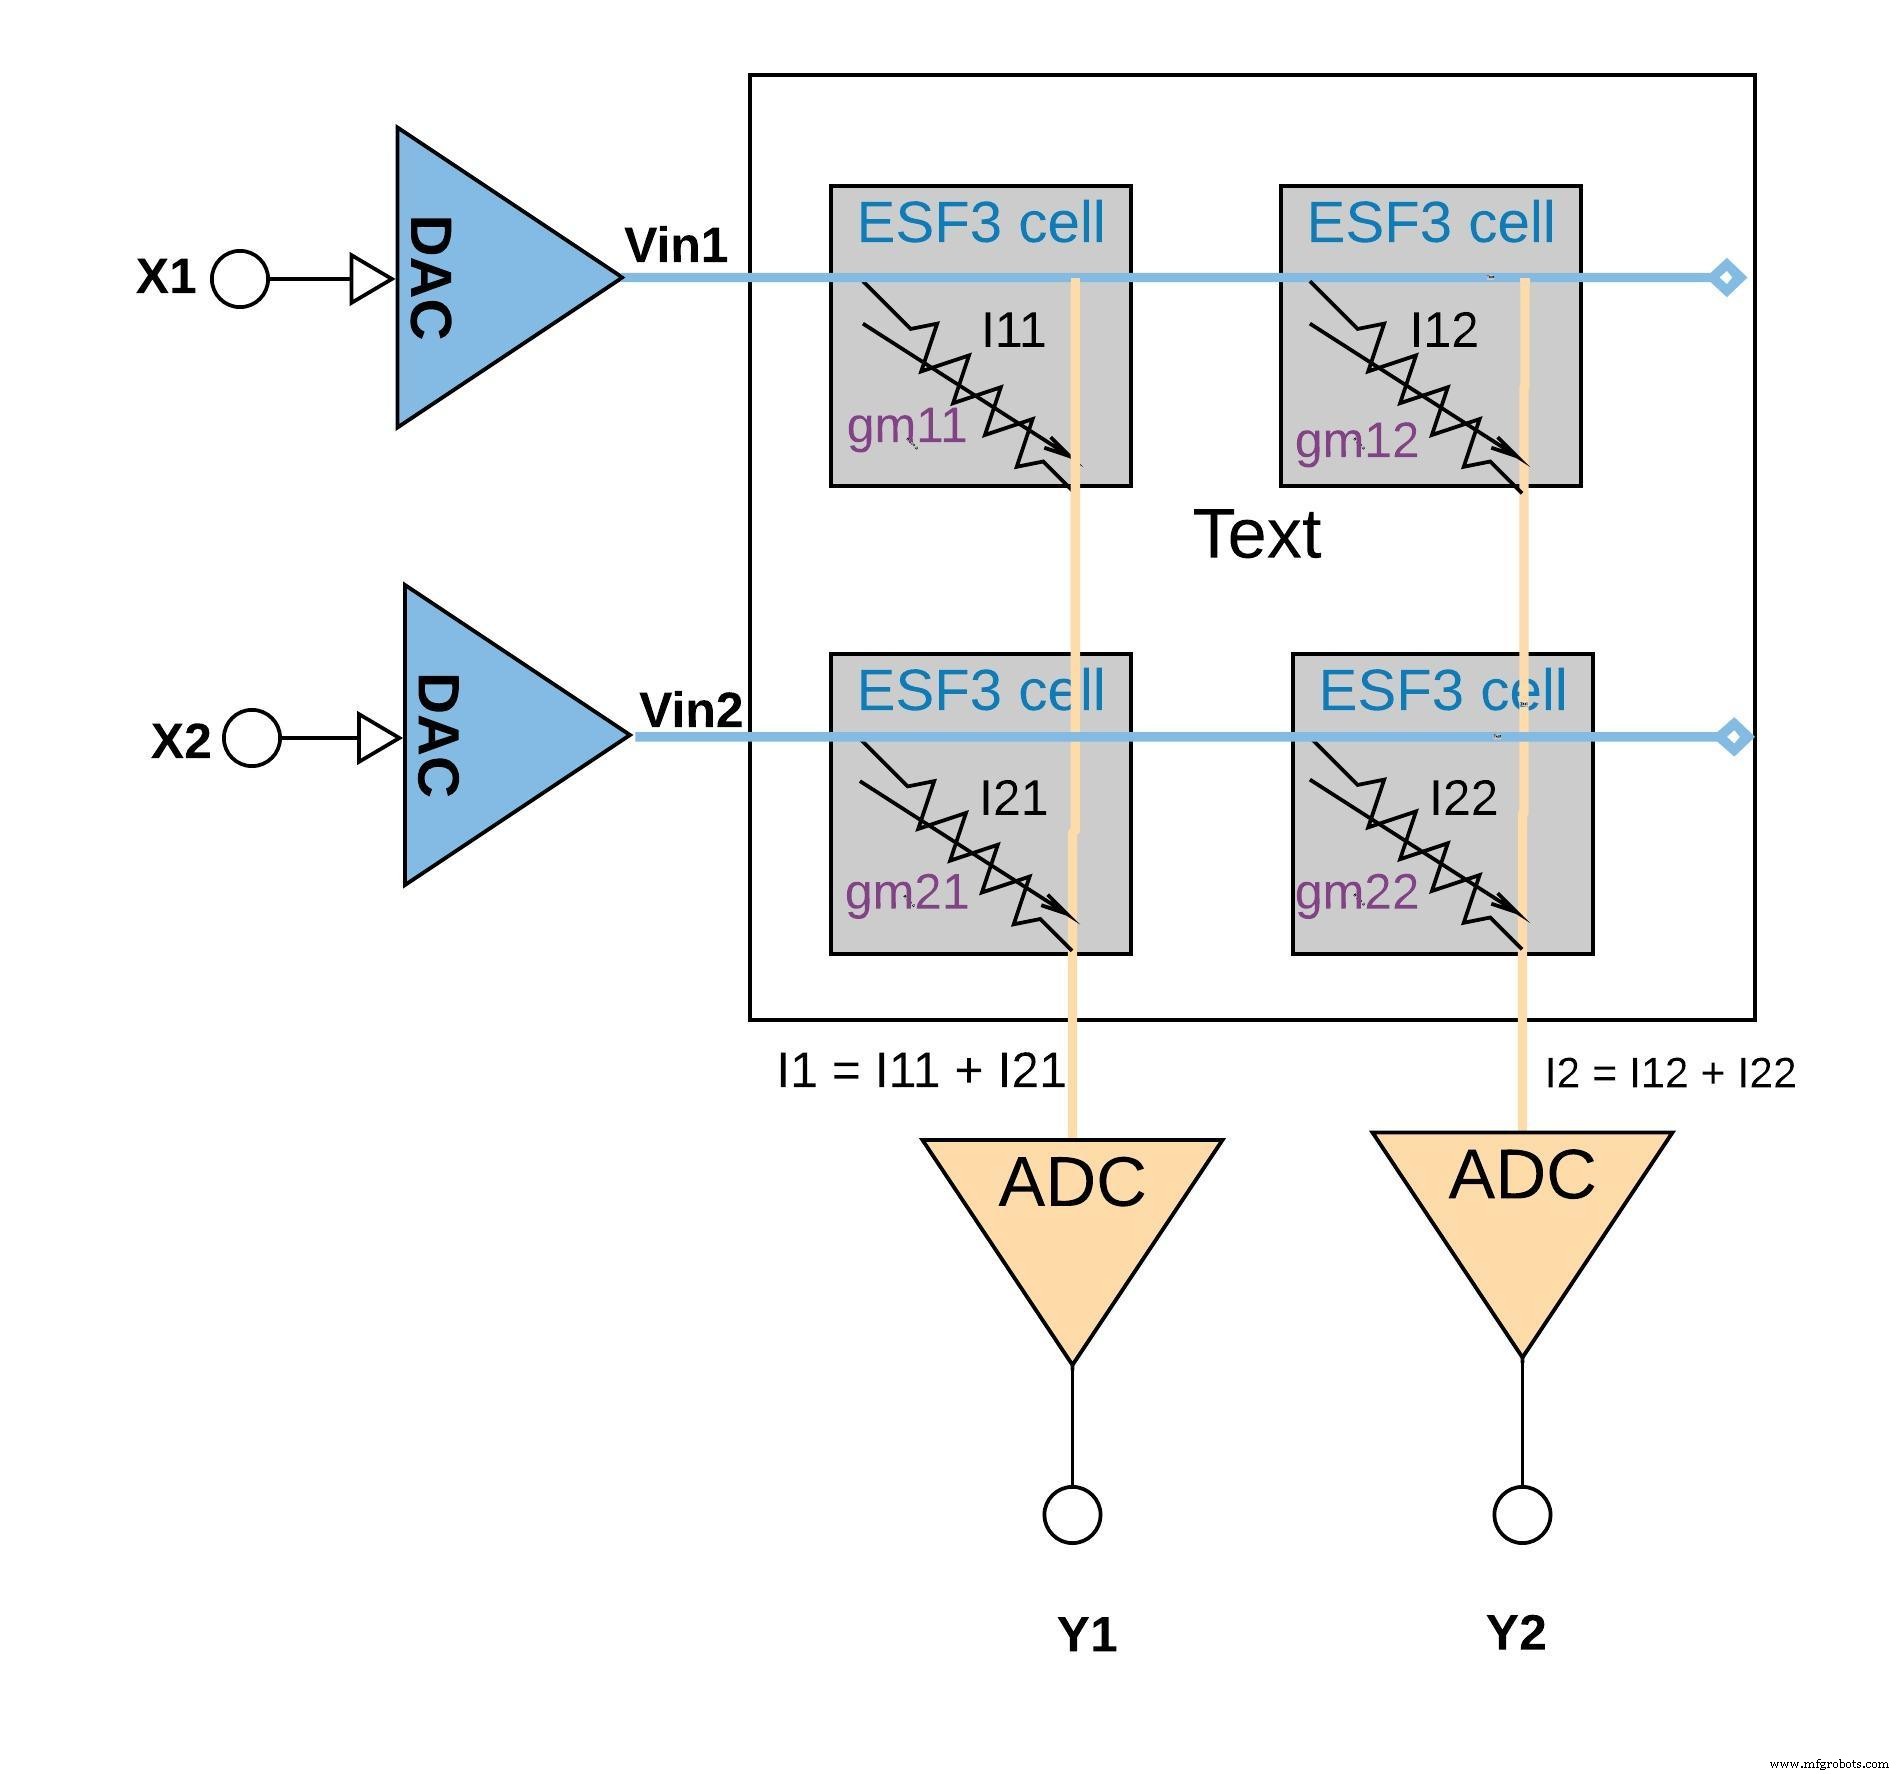 図6: ESF3アレイによる乗算累積演算(2×2)(出典:Microchip Technology)
より大規模では、重み行列を単一メモリアレイにマッピングできます。図7は全結合層の行列レイアウトを示します。
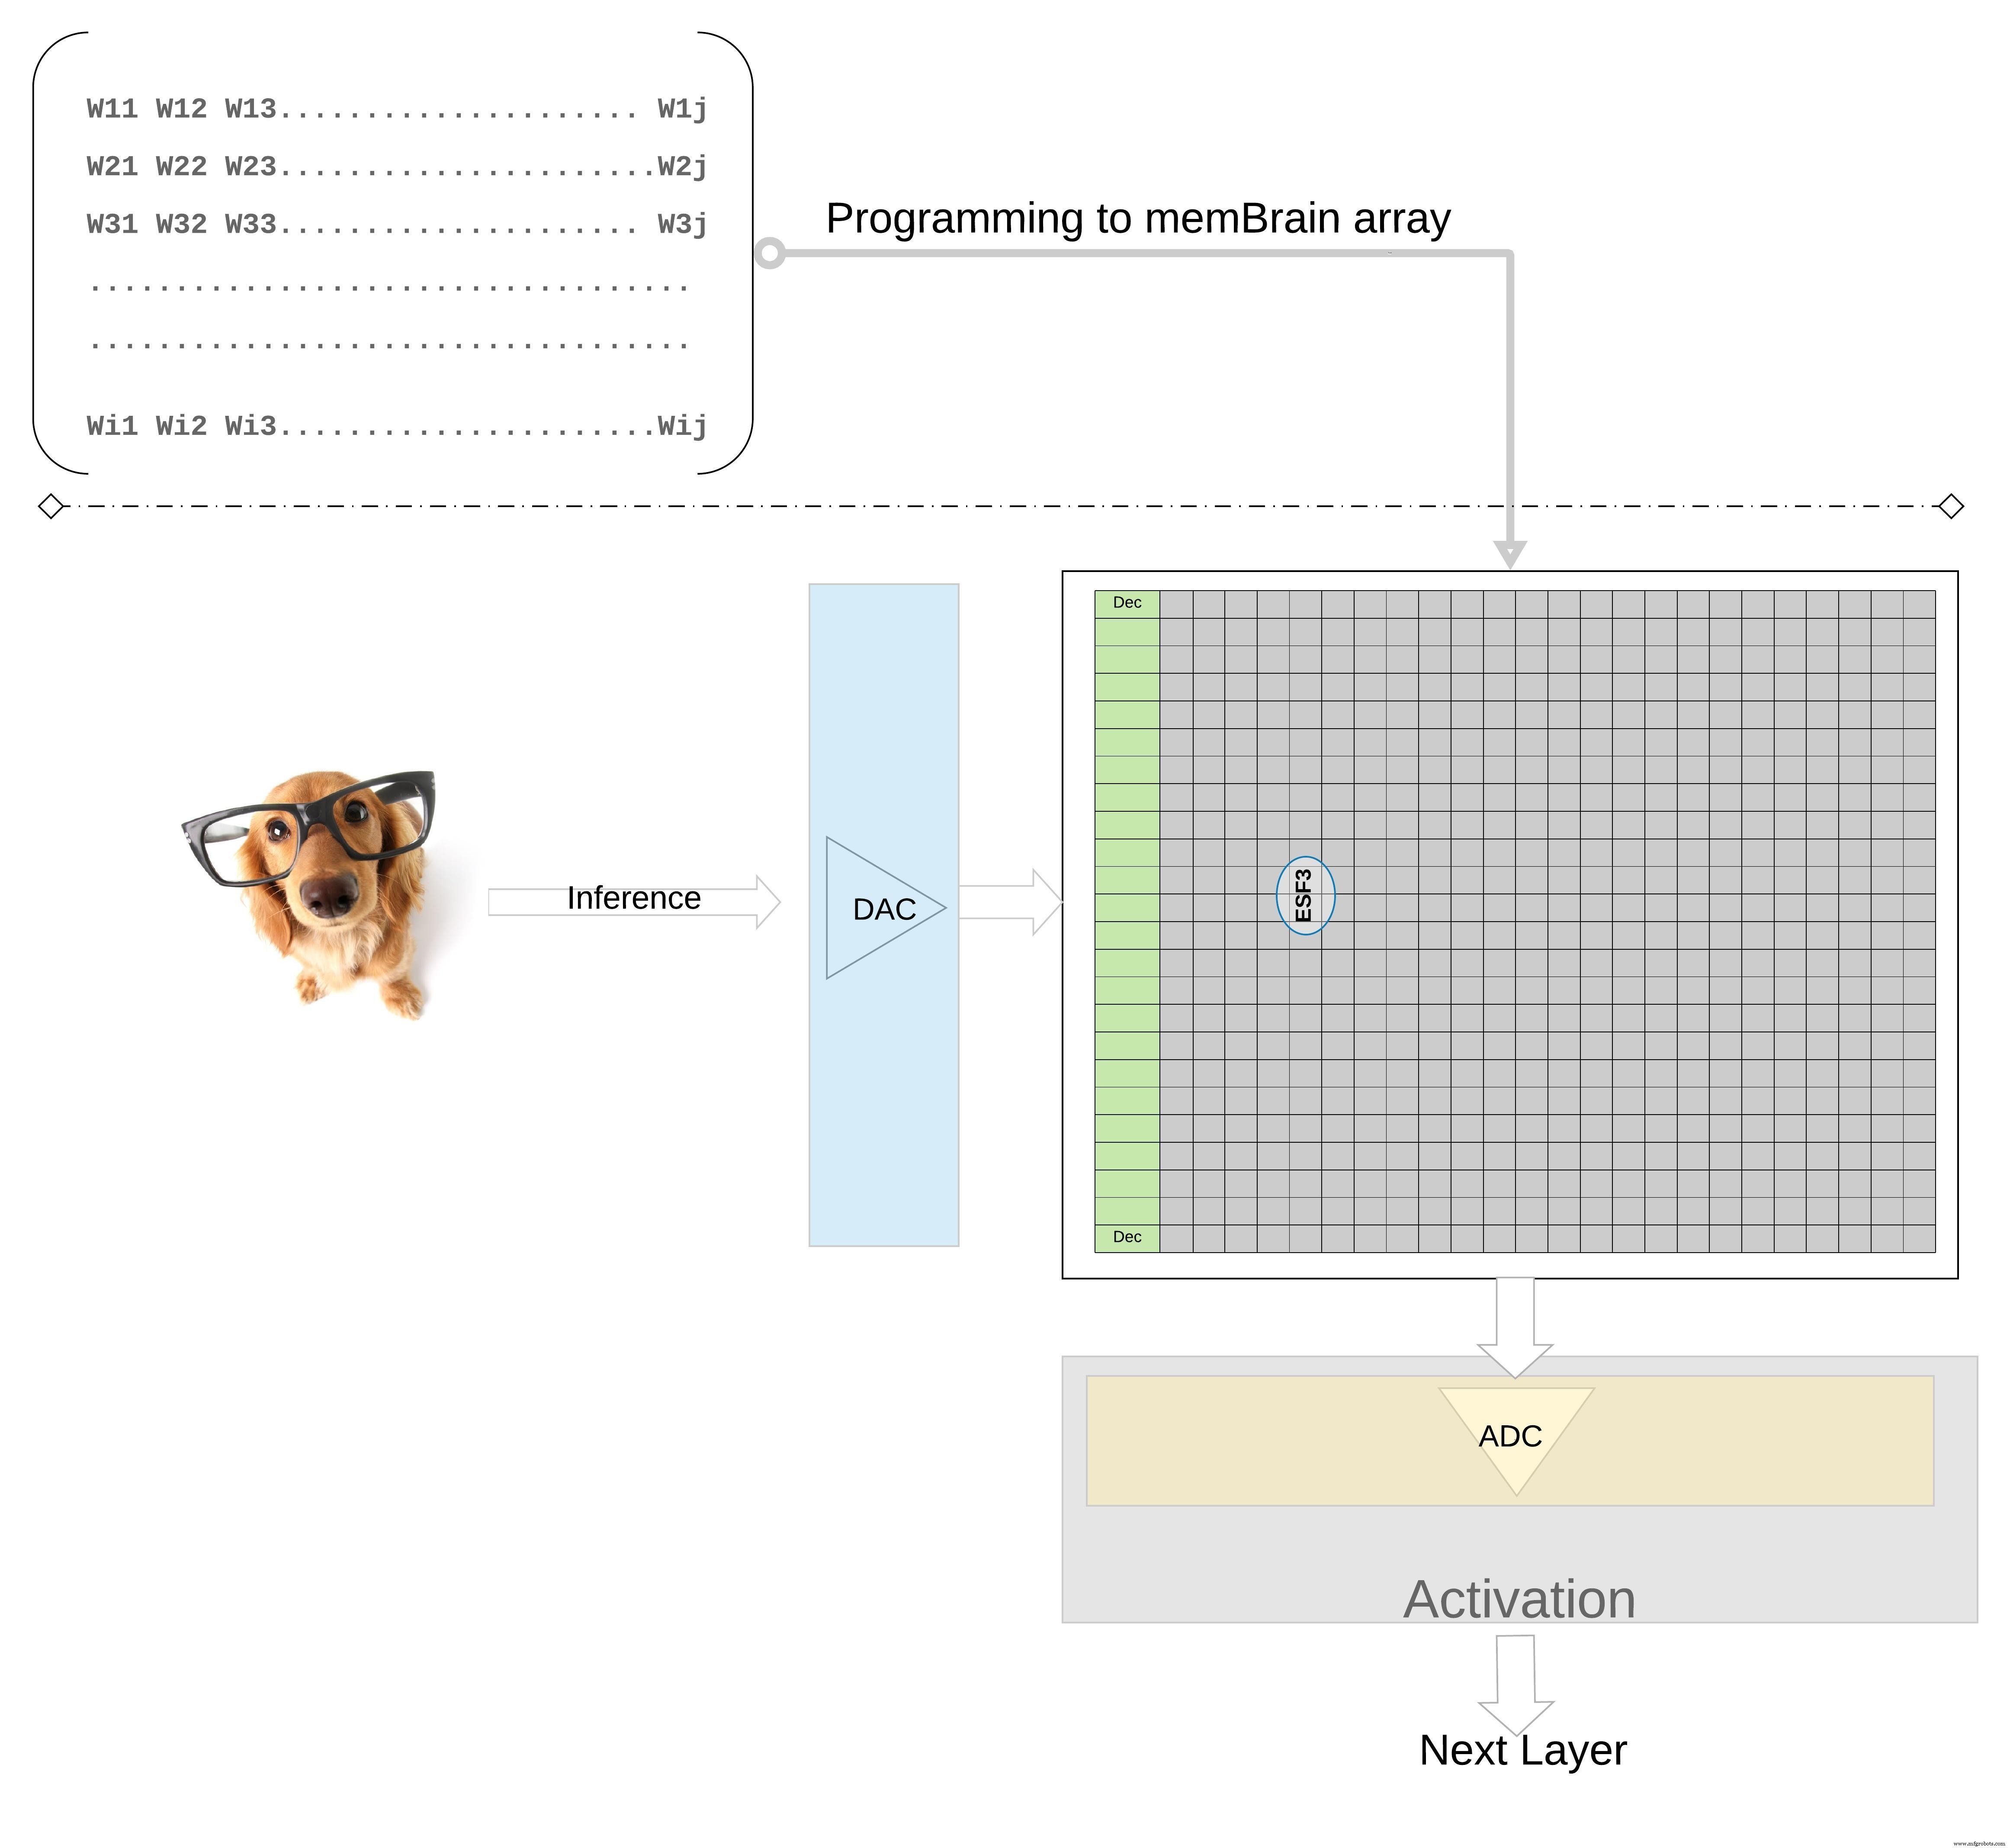 図7: 推論用重み行列メモリアレイ(出典:Microchip Technology)
推論フローはシンプルです:センサーデータをデジタル化し、DACでアナログ電圧に変換、アレイに入力、結果の列電流をADCでデジタル化して後続の活性化とプーリングステージへ。
モジュール性と拡張性
memBrainタイルはスタック可能に設計されています。図8は、複数タイルが共通のアナログ-デジタルインターコネクトを共有する3×4構成を示します。データは共有バスを介してタイル間を移動し、単一モノリシックダイなしで深層ネットワークの構築を可能にします。
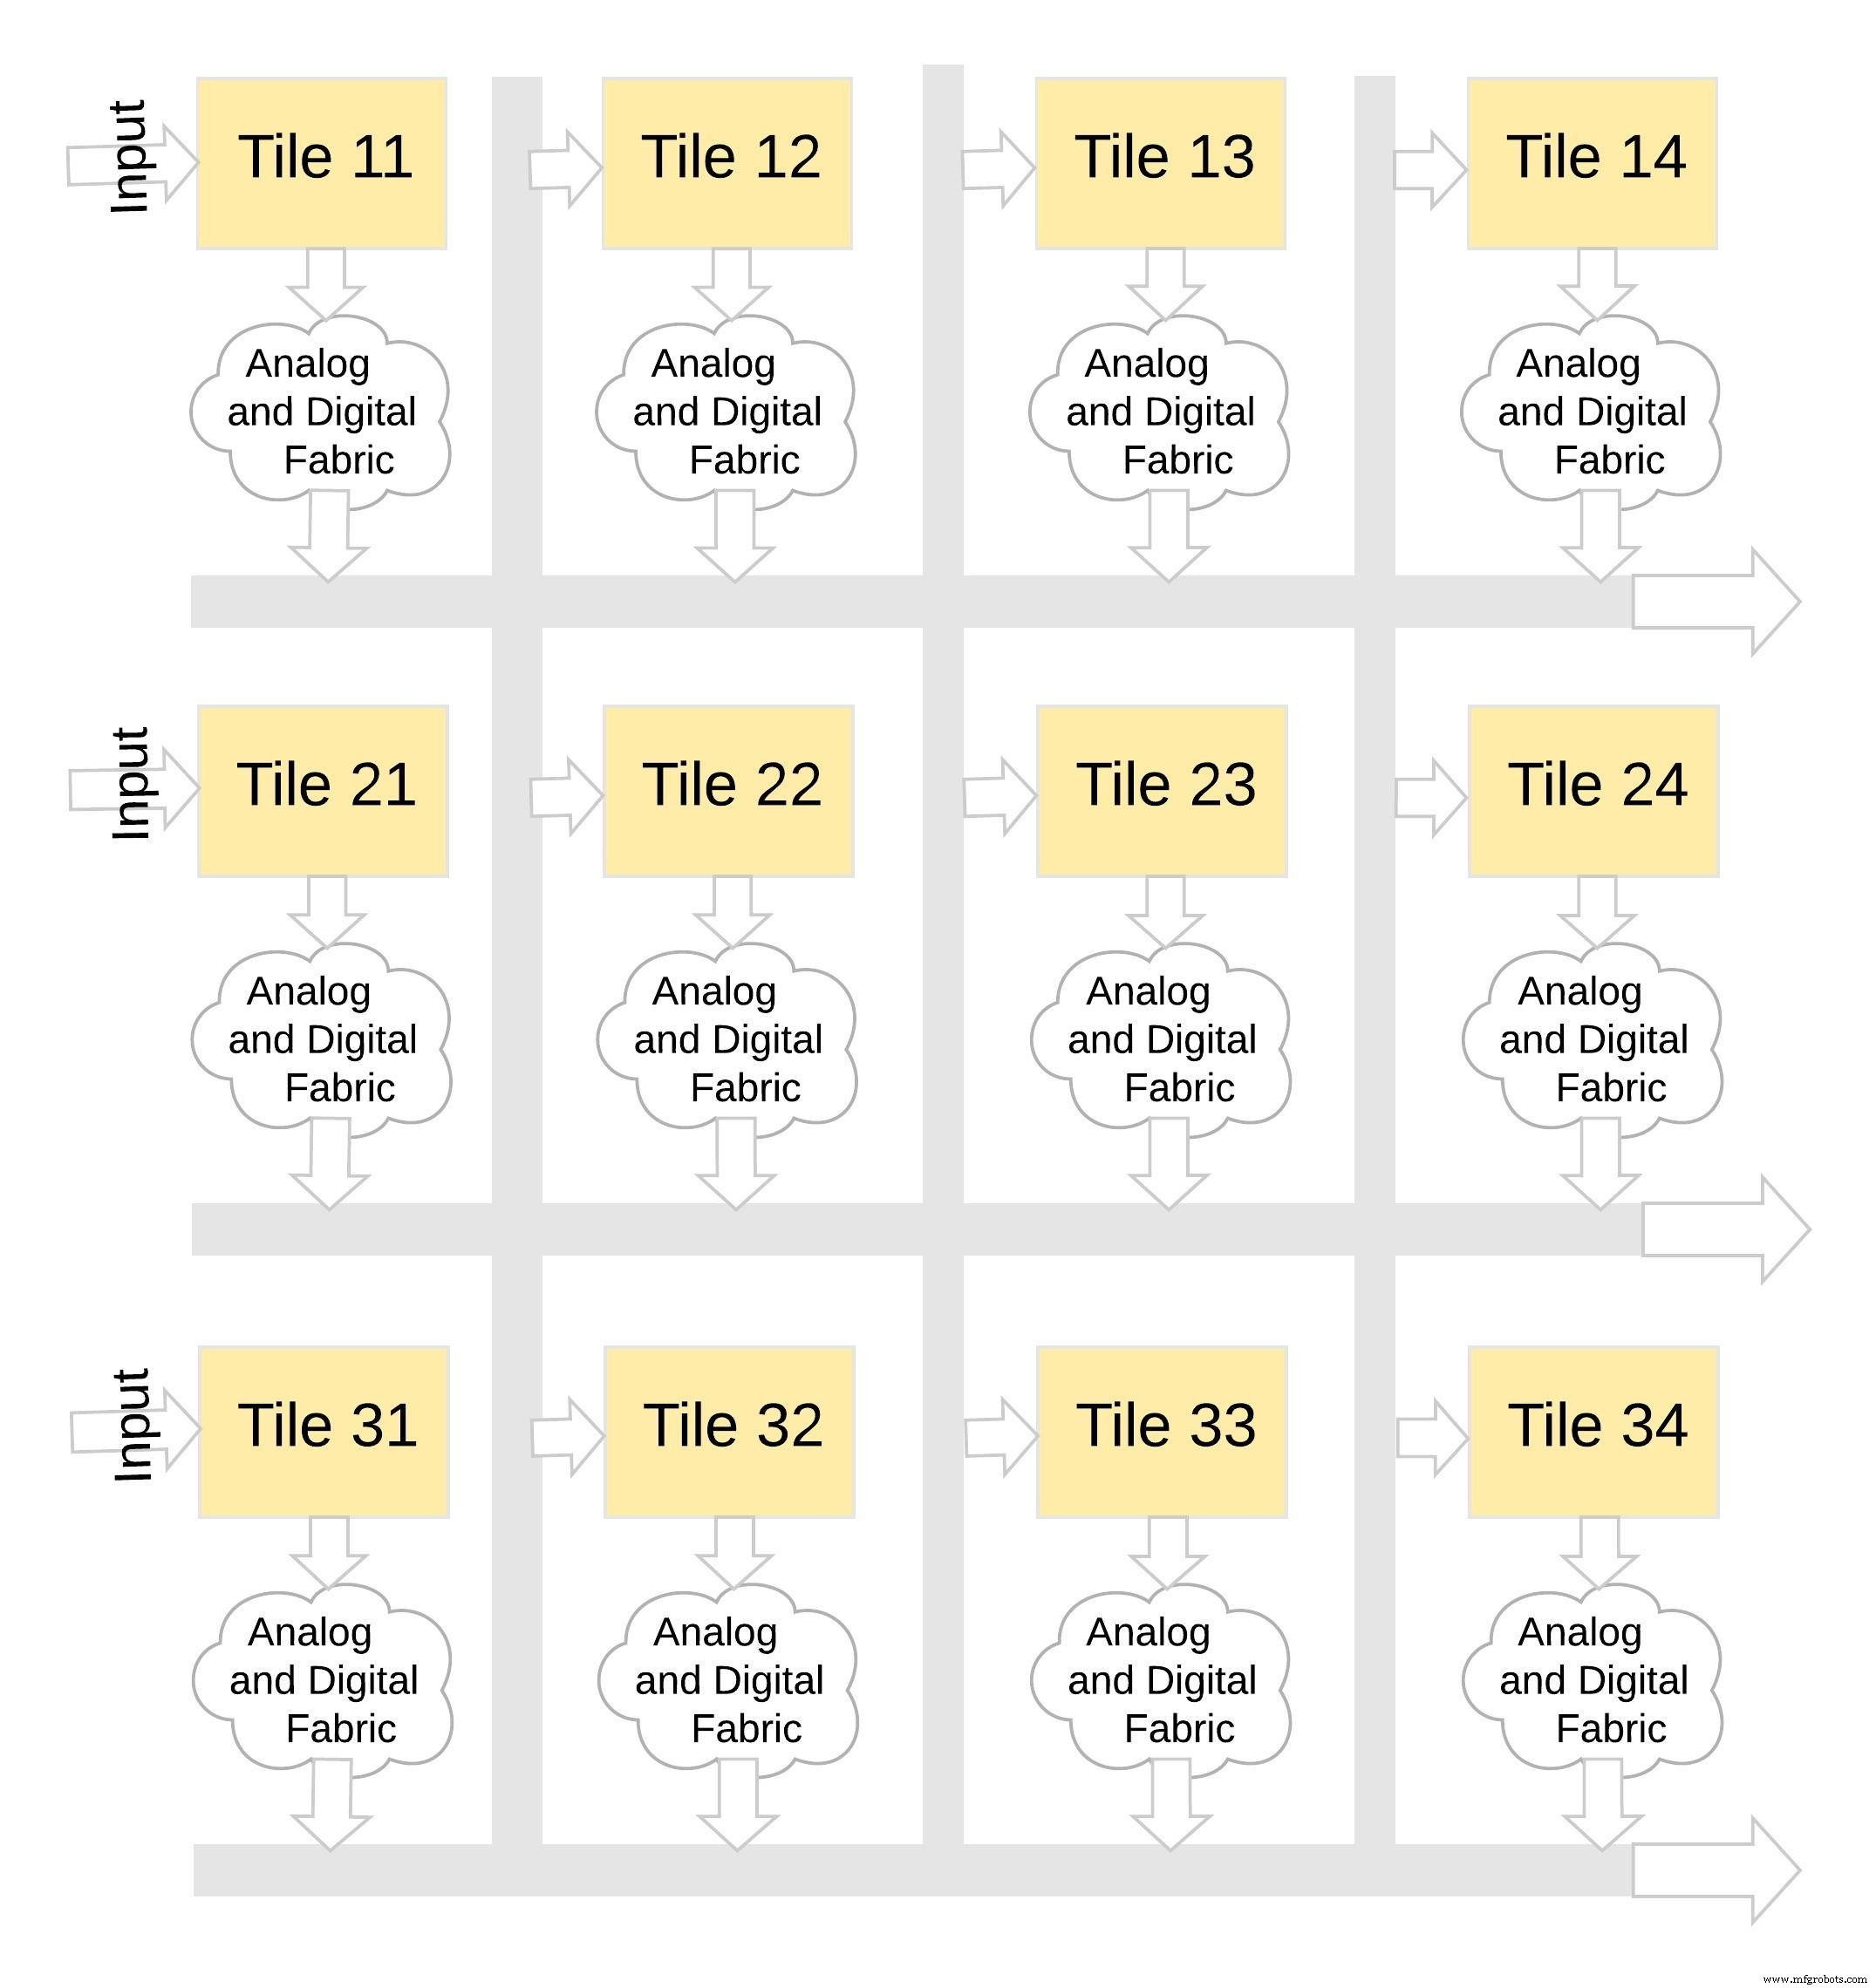 図8: memBrain™はモジュラー(出典:Microchip Technology)
ソフトウェア開発キット(SDK)
付属のSDKはフレームワーク非依存です。TensorFlow、PyTorch、その他のライブラリで訓練した場合でも、SDKがモデル量子化、マッピング、memBrainハードウェアへの展開を処理します。図9は訓練から推論までのワークフローを概説します。
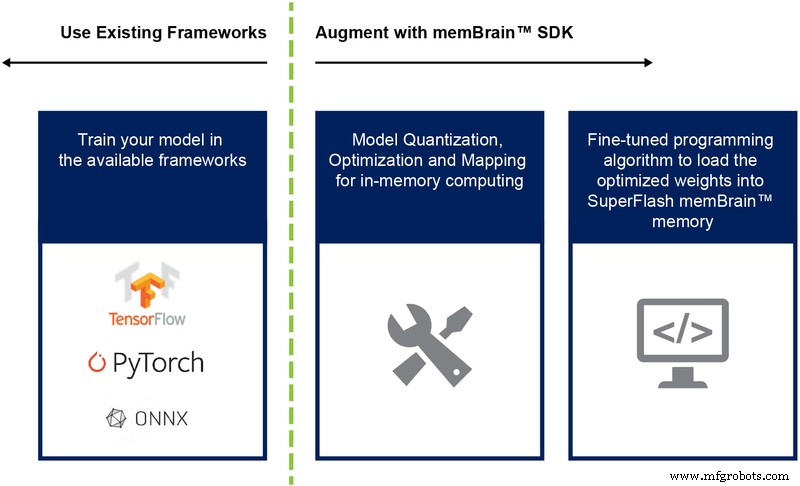 図9: memBrain™ SDKフロー(出典:Microchip Technology)
主な利点
- 超低消費電力——インメモリ計算でデータ移動を排除、フラッシュセルがサブスレッショルド動作、スタンバイ電力不要。スパース性も活用可能で、ゼロ重みや入力ではセルがアイドル状態
- コンパクトなフットプリント——1.5トランジスタ分割ゲートセルが4ビット値を格納、同等データには6トランジスタSRAMで24トランジスタ必要。ダイ面積を劇的に縮小
- 開発コスト削減——成熟フラッシュプロセスを活用し、超高密度ジオメトリの必要性を回避することで、エッジAI向けASICと比較してマスクセットコストとリードタイムを大幅に削減
エッジAIは変革的なアプリケーションを約束しますが、電力とコストが制限要因です。実証済みマルチレベルフラッシュテクノロジーに裏打ちされたアナログインメモリコンピューティングが、インテリジェントな推論をセンサーのすぐそばにもたらす実用的で低コストな道を提供します。
埋め込み
- 停電が電源装置を脅かす理由とその保護方法
- 小規模製造現場がコスト効率よくデジタルソリューションを導入する方法
- コネクテッドテクノロジーでサプライチェーン主要課題を解決
- エッジコンピューティングがエンタープライズITをどう変えるか:バランスの取れた視点
- クラウドコンピューティングがITチームをエンパワーする理由
- エッジコンピューティング解説:輸送、ユーティリティ、製造における実用ユースケース
- エッジコンピューティング:5つの落とし穴とその克服法
- IIoTデータを活用してリーン製造の収益性を高める
- エッジコンピューティング:インダストリー4.0を前進させる触媒
- エッジコンピューティングを採用すべき6つの説得力ある理由
- エッジコンピューティングと5Gがエンタープライズ変革を加速