



ルールベースとモデルベースを融合した高精度ドキュメント処理の実現
情報は力です。ほとんどの企業にとって、貴重なビジネス情報が文書の中に眠っています。企業が扱う文書のタイプ、サイズ、フォーマットが多様であることを考えると、インサイトを得るために効率的に文書を処理するのは困難です。
UiPathではこの課題を理解しています。最新のDocument Understandingフレームワークにより、お客様は文書のタイプ、フォーマット、量に関わらず、幅広い文書のデータ抽出と処理を簡単に自動化できます。これにより、お客様独自のニーズに最適なプロセスを用いて、柔軟に文書処理に取り組めます。
Document Understandingのメリットをより高い視点から知りたい方は、ホワイトペーパー「Document Understandingで運用効率を高め、リスクを軽減」をご覧ください。
この記事では以下を行います:
一般的な文書タイプと分類を整理
ルールベースとモデルベースのデータ抽出手法を検証
各標準アプローチを文書処理に適用する際、企業が直面する一般的な課題を確認
両文書処理アプローチをマルチアプローチデータ抽出法として組み合わせた場合に企業が得られるメリットを整理
始めましょう。
文書の全体像
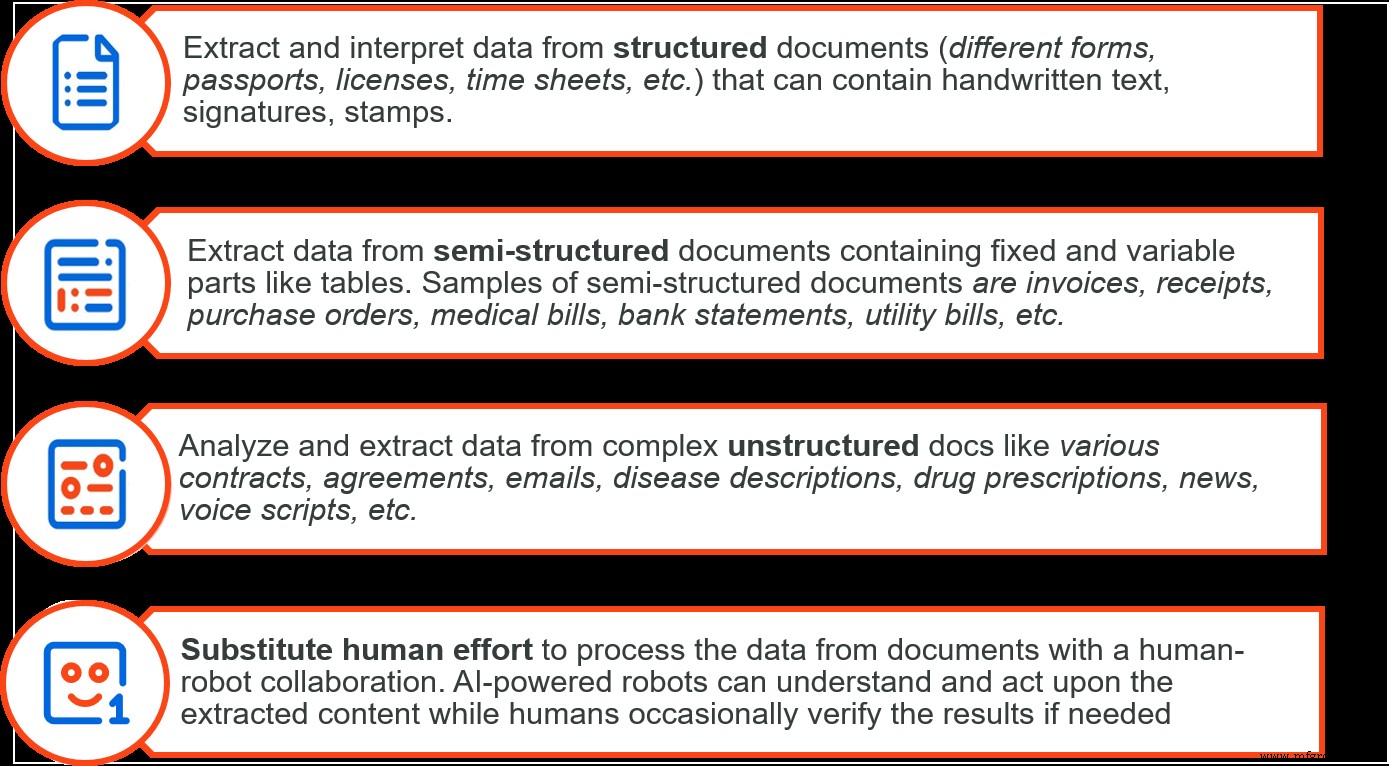
構造とフォーマットに基づき、文書は3つのタイプに分類できます。
1. 税務フォームのようにフォーマットが固定されている文書──これらは構造化文書と呼ばれます。
2. 契約書のように標準構造を持たない文書──これらは非構造化文書と呼ばれます。
3. レイアウトやデザインが異なるなど品質に差異があるが、似たタイプの情報を含む文書──これらは半構造化文書と呼ばれます。領収書、請求書、発注書がこのカテゴリの典型例です。
文書の分類に基づき、データ抽出方法論には2つの一般的なタイプがあります。ルールベース抽出は構造化文書を対象とし、モデルベース抽出は半構造化・非構造化文書の処理に用いられます。
ルールベースデータ抽出のメリットと限界
ルールベースデータ抽出は、一連のルールに基づいて文書からデータを抽出します。例えば、文書テンプレートを作成し、特定のデータ位置に基づくルールを適用できます。あるいは、テンプレートを作成せず、あるデータセットが文書内でどれくらい頻繁に使われるか(出現パターン)や、それらのデータ変数が文字列の中で通常どう見えるか(正規表現、regex)に基づくルールを適用することもできます。
前者はテンプレート化可能なフォームの処理に役立ち、後者はそのようなルールを作成するのが可能で容易な場合に使われます。ルールベース手法はセットアップと理解が容易で、文書処理において非常に効率的に機能します。しかし、構造化文書と、ごく一部の単純な半構造化文書に限定されます。
したがって、ルールベースデータ抽出技術は多くの文脈で有益ですが、明確な適用限界があります。テンプレートベース抽出は固定文書レイアウトに密接に結びついているため、レイアウトの変更はルールを破綻させ、再設定を必要とします。
同様に、正規表現ベースの手法は、状況が複雑になるにつれ実装、トラブルシューティングが困難になり、煩雑になります。しかし、ルールベース抽出ソリューションの代替アプローチがあります──モデルベースアプローチです。
モデルベースデータ抽出のメリットと限界
モデルベースデータ抽出方法論は、機械学習(ML)に基づいています。これらの手法は、多様な文書セットから学習する能力により強力です。自然言語処理(NLP)や統計学習といった洗練された技術を用いてこれらを実現します。
UiPath Validation Stationは、人間が介在する(Human-in-the-loop)機能をユーザーに提供し、モデルがその場で学習し、データの変化に自己適応できるようにします。人工知能(AI)を活用した技術は、通常、半構造化・非構造化文書からのデータ抽出に用いられます。例えば、領収書と請求書の処理といったシナリオに対応するため、MLモデルをDocument Understandingフレームワークで作成しています。
関連記事:AIを活用した請求書・領収書処理の自動化
モデルベース抽出技術を使う課題は、MLモデルの作成と実装に時間と専門知識がかかることです。しかし多くのシナリオで、モデルベース手法は異なる文書構造や内包物を学習・適応する能力で優れています。
マルチアプローチデータ抽出を採用する
すべての文書処理ニーズに対応する「銀の弾丸」はありません。ルールベースとモデルベースの両アプローチは強力なツールですが、企業が管理する文書の範囲を最適に処理する能力には限界があります。
一部の構造化文書は、ルールベース方法論だけでは不十分で、ルールやテンプレートでは抽出できないデータがあります。同様に、モデルベース手法だけでも、すべての非構造化・半構造化文書には対応できません。
ユーザーが異なるアプローチを簡単に組み合わせ、単一の文書から情報を抽出できるようにしたいと考えました。そこで、Document Understandingフレームワークを設計し、個々のアプローチが課す制約を克服できる力を与えました。複雑な文書を扱い、データ抽出プロセスで最高レベルの精度を達成したい場合、マルチアプローチデータ抽出の使用を強く推奨します。
高速で正確なマルチアプローチデータ抽出
柔軟なフレームワークを用いて、UiPath Studioで複数のデータ抽出技術をワークフローに直接ドラッグ&ドロップするだけで、文書処理アプローチを組み合わせられます。
データ処理用の抽出機能を簡単に設定し、抽出実行の優先順位を設定し、特定の抽出結果を有効とみなす閾値値を設定できます。これにより、可変的な文書構造も、データ抽出の複雑なルールも、もはや課題ではありません。同時に、エンドツーエンド自動化の中で、最新のAI技術により、より速く、はるかに正確な文書処理が実現します。
ご興味をお持ちですか?
効率的で正確な文書抽出・処理能力を持つことは極めて重要です。マルチアプローチデータ抽出に注力することで、UiPathのお客様にとって文書処理と分析を可能な限り簡単にしたいと考えています。
現在、拡張Document Understanding機能は、先行パイロット参加ユーザー向けにSaaSのベータ版として提供されています。これらの機能と他の高度なDocument Understandingツールは間もなく利用可能になる予定です。その間、UiPathエンタープライズ試用版に登録して、UiPath Document Understandingソリューションへのアクセスをお勧めします。
自動制御システム
- 米陸軍、革新的センサーと予測分析で状態基準保全(CBM)を前進
- 食品・加工業界のための衛生的設計:清浄性からコスト削減へ
- ABB、データセンター向け最先端クラウドオートメーションを発表
- Ambarella、Lumentum、ON Semiconductorが次世代AIoTデバイス向けAI駆動3Dセンシングソリューションを発表
- インダストリアルIoTと予測分析:製造効率を加速する
- フリート管理の革命:AIとIoTの統合によるスマートな運用
- IIoTとデータ分析でEHSを変革:安全性・効率・コスト削減を実現
- センサーと運用データが大手トラックメーカーの収益性を向上させる仕組み
- エッジAI:処理がデバイス層へシフトする理由
- フォグコンピューティング解説:IoTデータフロー変革とクラウド負荷軽減
- 産業AIoT:AIとIoTの融合でインダストリー4.0イノベーションを推進