



データサイエンス・ライフサイクル完全マスター:包括的ガイド
ビッグデータの到来以来、現代のコンピュータサイエンスは新たな能力と処理能力のベンチマークに到達してきました。現在、100テラバイト以上のデータセットを生成するアプリケーションを見かけることは珍しくなく、これはビッグデータと見なされます。
このような大量の情報を手元に置くと、整理整頓が行き届かず、無駄なコンテンツに時間を浪費しやすくなります。これらは、ビッグデータプロジェクトの効率と効果を高める方法論に従うことが非常に重要である2つの理由です。
図1. 現代のデータサイエンスは、ビッグデータとしても知られる非常に大規模なデータセットを扱います。
データサイエンス・ライフサイクルは、ビッグデータプロジェクトの定義、収集、整理、評価、展開を支援するフレームワークを提供します。これは、論理的な順序で配置された一連のステップで構成される反復的プロセスであり、フィードバックと方向転換を促進します。
ライフサイクルのシークエンスはどのようなものでしょうか? 答えは、誰もが従う単一の普遍的なモデルは存在しないということです。ビッグデータプロジェクトに取り組む多くの企業は、データサイエンス・ライフサイクルを自社のビジネスプロセスに適応させ、通常はステップを追加します。それでも、すべての多くのモデルとプロセスフローには共通の分母があります。この記事では、最初期かつ最も人気のあるデータサイエンス・ライフサイクルモデルの一つであるCRISP-DMプロセスモデルを使用します。
CRISP-DMモデル
CRISP-DMは「Cross Industry Standard Process for Data Mining(データマイニングのための業界横断標準プロセス)」の略です。1999年に、IT(情報技術)研究促進のための欧州プログラムであるESPRITによって初めて公開されました。CRISP-DMモデルは、ビッグデータプロジェクトを導く6つのステップまたはフェーズで構成されています。ステークホルダーに問題について重要な質問を投げかけ、答えさせることで、ビジネスについて考えることを促します。
CRISP-DMモデルの6つのフェーズを詳細に見ていきましょう。
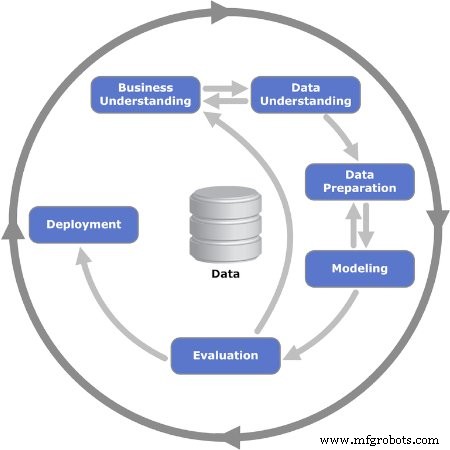
図2. CRISP-DMモデルの反復的な6フェーズを示す。画像提供:Kenneth Jensen
フェーズ1:ビジネス理解
最初のフェーズは、問題を定義し目標を設定するいくつかのタスクで構成されます。ここでプロジェクトの目的が、ビジネス、言い換えれば顧客に焦点を当てて設定されます。通常、ビッグデータプロジェクトに取り組むために編成されたチームは、社内の別の部門や領域など、顧客にソリューションを提供しなければなりません。
ビジネスニーズや問題が確立されたら、次のステップは成功基準を定義することです。これらは主要業績評価指標(KPI)やサービスレベル合意(SLA)などであり、進捗と完了を客観的に評価する手段を提供します。
次に、リスク、ロールバック計画、予備対策、そして何よりリソースの可用性を特定するために、ビジネス状況を分析する必要があります。マイルストーンとリソースを含むプロジェクト計画が立てられます。
フェーズ2:データ理解
前のフェーズで基礎が確立されたら、データに焦点を当てる段階です。このフェーズは、必要と考えられるデータの最初の定義から始まり、それについての詳細を文書化します:どこで見つかるか、データの種類、フォーマット、異なるデータフィールド間の関係など。
最初の文書化が完了したら、最初のデータ収集を実行します。これにより、構造がどのように形成されつつあるかの有用なスナップショットが得られます。この情報のスナップショットは品質の観点から評価されます。
フェーズ3:データ準備
第3フェーズは前のフェーズを強化し、データセットをモデリングのために準備します。最初の収集から得られたデータフィールドをさらにキュレーションし、不要と判断された情報をセットから削除します:これが「データクリーニング」と呼ばれます。
また、特定の情報を利用可能な他の情報から導き出す必要がある場合や、結合する必要がある場合もあります。言い換えれば、データを処理して最終的なフォーマットを生成する必要があります。
フェーズ4:モデリング
このフェーズで最も重要なタスクは、収集したデータを処理するアルゴリズムを選択することです。この文脈では、アルゴリズムとはビッグデータプロジェクト向けに設計されたコンピュータソフトウェアにプログラムされた、一連の手順とルールを指します。
多くのアルゴリズムが使用可能です:線形回帰、決定木、サポートベクターマシンなどが例です。問題を解決するために適切なアルゴリズムを選択するには、経験豊富なデータサイエンティストが持つスキルが必要です。
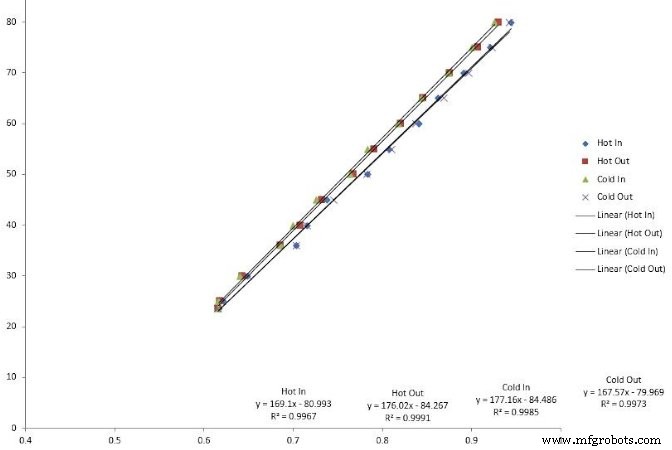
図3. 線形回帰はビッグデータモデリングで使用されるアルゴリズムの一種です。
次のステップは、アルゴリズムをソフトウェアアプリケーションにコーディングすることです。ここでテストフェーズも計画され、テストと検証用の特定のデータセットが割り当てられます。
フェーズ5:評価
最初からアルゴリズムを選択するのが難しい場合もあります。この場合、科学者はいくつかのアルゴリズムを実行し、結果を分析して最終決定に至ります。テストフェーズが完了したら、結果の完全性と正確性についてレビューされます。
より重要なのは、結果がソリューションにつながるかどうかを評価する機会だということです。反復モデルでは、ここで主要な反復シーケンスを開始するか、最終フェーズへ進むかの判断がなされる重要な分岐点となります。
フェーズ6:展開
ここでプロジェクトがテスト環境から本番環境へ移行します。展開スケジュールと戦略の計画は、リスクと潜在的なシステムダウンタイムを減らすために非常に重要です。
モデル図ではこれがプロジェクトの終わりを示唆していますが、その後もまだ多くのフォローアップステップがあります:監視とメンテナンス。監視は、ゴーライブ直後の密接な観察期間、いわゆる「ハイパーケア」です。メンテナンスは、実装されたソリューションの維持とアップグレードのための半永久的なプロセスです。
ビッグデータが「ビッグ」と呼ばれるのには理由があります:解析すべきデータが大量に存在します。データサイエンス・ライフサイクルモデルの一つを実装することで、予知保全などのプロセスでどの情報を保持・活用すべきかを判断できます。
モノのインターネットテクノロジー
- 音の活用:スマートフォンを超えたデータ伝送の変革
- 医療分野におけるAI・深層学習のアウトソーシング:データプライバシーの保護
- 予知保全:インダストリー4.0を活用した無停止生産の実現
- SIMライフサイクルの合理化:CSP向けデジタル戦略
- IoTの民主化:次世代衛星IoTがもたらす普遍的で手頃な接続性
- IoTデータの価値を引き出す:セキュアでインサイト主導の戦略
- ドメインエキスパートにデータサイエンスを授け、よりスマートな製造インサイトを実現
- ダイレクト・デバイス接続が産業IoTの次のマイルストーンとなる理由
- アナログ測定がプラントパフォーマンスを向上させる理由
- Tableau:生データを戦略的インサイトに変える
- 産業データサイエンス成功のための基盤構築