



データレイク vs ビッグデータ:産業アプリケーションのための正しいアプローチ選択
「データレイク」と「ビッグデータ」は、しばしば誤解され誤って使用される2つの現代用語です。大量のデータを暗示するため、これらの用語は時々入れ替えて使われます。しかし、現在の定義が完全に確立されていないとしても、データレイクとビッグデータは異なるものです。
図1. 現代のデータは多くのソースから来て、さまざまなタイプがあり得る。画像提供:Analytics Vidhya
歴史的背景
まず簡単な歴史的背景を見てみましょう。2000年代後半、FacebookやTwitterなどのソーシャルメディアプラットフォームの爆発的成長により、多くのデータサイエンティストが、こうしたプラットフォームが大量の貴重な個人データを生成する潜在能力を持つことに気づきました。その結果、データ処理と分析を容易にする新しいソフトウェアアプリケーションが開発されました。代表的な例がApache Hadoopで、本質的にはビッグデータレベルの情報を処理できるオープンソースアプリケーションのツールキットです。
次の10年間で、モノのインターネット(IoT)が登場しました。これにより、個人の嗜好やパターンに関する洞察を提供し、製品自体に関する情報も送信できる、何百万ものデータソースへの扉が開かれました。
同時に、機械学習が重要な進歩を遂げ、産業界での実用的な応用を見出しました。これにより、特に自動化プロセスにおいて、産業界で大量のデータを扱う必要性が高まりました。
すべての予測は、世界で利用可能なデータの総量が今後数年間で加速度的に拡大し続けることを示しています。参考までに、2016年には世界が年間インターネットトラフィック1ゼタバイトというマイルストーンを通過しました。1ゼタバイトは1兆ギガバイトに相当します。
年間インターネットトラフィックは2021年に3ゼタバイトを超えると予測されています。これらの予測と、クラウドコンピューティングの拡張された能力は、ビッグデータ(とデータレイク)の価値と用途が、おそらくまだ始まったばかりであることを示しています。
ビッグデータとは?
単純にボリュームの観点から見ると、ビッグデータの定義は移動する標的です。データ量と利用可能なストレージスペースが増え続けるにつれて、大量の情報と見なされる基準も上がり続けます。
今日、サイズ100テラバイト以上のデータリポジトリは一般的にビッグデータの範囲内と見なされます。ソーシャルメディアプラットフォームなどの大規模データリポジトリは、数ペタバイトの範囲にある可能性があります。
ビッグデータを定義するもう一つの基準は、情報量がSQLのような従来のコンピュータツールでは処理できない場合です。例えば今日、データベースが年間1テラバイトに達することは珍しくありません。しかし、SQLアプリケーションがより強力になっているため、この規模のデータベースはまだ管理可能であり、通常はビッグデータとは見なされません。
ビッグデータの4Vモデル
これまでボリュームの観点からビッグデータの定義を見てきました。考慮すべき他に3つの重要な要素があります:速度、多様性、真実性。これらがボリュームと合わせて4Vモデルを形成します。
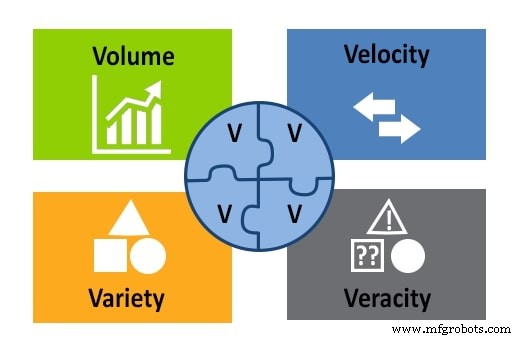
図2. ビッグデータの4Vモデル:ボリューム、速度、多様性、真実性。画像提供:APSense
多様性とは、ビッグデータリポジトリに格納されるあらゆる種類のデータを指します:テキスト、画像、音声、動画など。また、データが複数のソースから来ることも指します。
速度はビッグデータにおいて重要な考慮事項です。情報が常にストリーミングされ続けるためです。速度は、データが収集、生成、配布されるスピードに関係します。
真実性は、データの正確さと品質を測定し、データサイエンティストが分析や結論導出に使用できるかどうかを評価します。
ビッグデータを理解したところで、データレイクを見てから、これらを制御システムでどう活用するかを掘り下げましょう。
データレイクとは?
データレイクは、将来価値があるかもしれないしないかもしれない大量の生データ、つまり目的が100%明確でない情報の一元化されたリポジトリです。データレイクは、リレーショナルおよび非リレーショナルデータベースを、他のタイプのファイルやエンティティとともに格納できます。
データレイク内の情報は処理も整理もされていませんが、すべての入力と出力が考慮されて良いアーキテクチャを作るように構造化されています。
データレイク vs ビッグデータ
データレイクはビッグデータアプリケーションの一インスタンスです。4Vモデルで説明された基準に従いますが、いくつかの特徴が追加されています。ボリュームの面では、データレイクは平均的にビッグデータと見なされる範囲の下限付近にあります。
データレイクの情報には多様性がありますが、条件は「未処理の生データのみ」であることです。入出力速度は他の最新システムと同様に重要であり、データ品質評価は適切に設計されたデータレイクで実行されます。
データの産業応用
高度な自動化により、工場現場で扱う情報量が急速に増加しています。これにより、製造業やその他の産業プロセスがビッグデータの領域に入り、いくつかのビジネス活動でデータレイクのようなツールが採用されるようになっています。
代表的な例が予知保全です。機械的または電気的故障を予測する能力は非常に価値があり、修理コストの大幅な削減をもたらします。データレイクは、ログファイル、複数のセンサー、入力デバイスからの情報をまとめ、トレンドを理解し問題を予測するのに役立つ有用なツールです。
機械学習は、ロボットに外部環境の変化に適応するのを助ける情報を提供する概念です。情報の取得は予知保全と似ていますが、評価とプロセスへの変更が自動的にシステムコントローラーにフィードバックされるという追加ステップがあります。機械学習データは構造化されたデータレイクに格納できます。
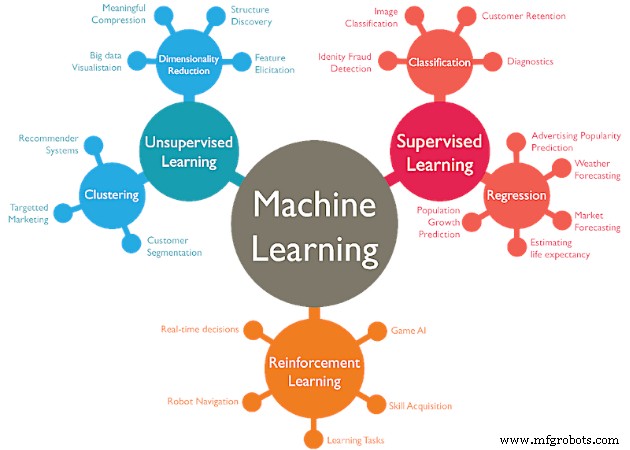
図3. 機械学習にはそれぞれ大量のデータを必要とする複数の戦略がある。画像提供:WordStream
結論として、データレイクはビッグデータアプリケーションの一インスタンスです。これら2つのデータの見方は連携できます。ビッグデータとデータレイクの両方を活用することで、制御エンジニアは故障予測、メンテナンスルーチンの作成、施設のデジタルトランスフォーメーションの推進など、さらなることが可能になります。
あなたの仕事では、ビッグデータとデータレイクを何に活用していますか?
モノのインターネットテクノロジー
- GE、産業データ・分析専用プラットフォーム「Predix Cloud」を発表
- 市場成長を牽引するトップ7インダストリアルIoTアプリケーション
- Cervozガイド:産業用途向け信頼性の高いフラッシュストレージ選定
- コネクテッド センサーとスマート プロセッサがインダストリー 4.0を駆動
- 将来展望:生産卓越性に向けた産業用IoTの推進
- 産業用IoT(IIoT)が直面するトップ4の課題
- 高インパクトなセンサー駆動IoTアプリケーション構築の6つの核心原則
- RTUを活用した産業オペレーションにおけるビッグデータインサイトの獲得
- 産業データサイエンス成功のための基盤構築
- 産業用IoT:データ取得からリアルタイム意思決定へ
- ビッグデータは医療予算を革命できるか? Lux Researchの洞察