



デュアル深層学習モデルの統合で産業オートメーションを強化:アンサンブル学習の実践
深層学習は、産業アプリケーションを含むさまざまな分野で新たな応用を見出している、データアナリストの武器庫における貴重なツールです。深層学習の基本原理は、大量のデータを使用して正確な予測を行えるモデルを構築することです。
産業オートメーションエンジニアが2つの深層学習モデルを組み合わせる必要に迫られる小さな例を考えてみましょう。スマートフォン会社が、複数のスマートフォンモデルを製造する生産ラインを持っています。深層学習アルゴリズムを採用したコンピュータビジョンが、生産ラインの品質管理を実行しています。
現在、生産ラインは2機種のスマートフォンを製造しています:Phone AとPhone B。モデルAとモデルBが、それぞれPhone AとPhone Bの品質管理を実行しています。同社が新しいスマートフォン「Phone C」を発表しました。生産施設では、第3の電話機の品質管理を行う「モデルC」という新しいモデルが必要になるかもしれません。ゼロから新しいモデルを構築するには、膨大な量のデータと時間が必要です。
図1. 動画提供:Matt Chan
別の選択肢は、モデルAとBからの学習を組み合わせてモデルCを構築することです。結合されたモデルは、重みへのわずかな調整で品質管理を実行できます。
モデルを組み合わせる必要があるもう一つのシナリオは、新しいモデルが2つのタスクを同時に実行する必要がある場合です。2つの深層学習モデルがこれらのタスクを実行できます。データセットを分類し、各カテゴリで予測を行う必要があるモデルは、大規模データセットを分類できるモデルと予測を行えるモデルの2つを組み合わせることで作成できます。
アンサンブル学習
複数の深層学習モデルを組み合わせることをアンサンブル学習と呼びます。これは、深層学習モデルのより良い予測、分類、またはその他の機能を実現するために行われます。アンサンブル学習は、異なる深層学習モデルの結合機能を持つ新しいモデルを作成することもできます。
ゼロから新しいモデルを訓練するのと比較して、結合モデルの作成には多くのメリットがあります。
- 結合モデルの大部分の学習が元のモデルから派生するため、結合モデルの訓練に非常に少ないデータで済む
- 新しいモデルをゼロから構築するより、結合モデルの構築にかかる時間が短い
- モデルを結合する際、より少ない計算リソースで済む
- 新しい結合モデルは、元となったモデルより高い精度と高い能力を持つ
これらのアンサンブル学習のさまざまな利点により、新しいモデルを作成するためによく実行されます。それぞれの深層学習アルゴリズム、パッケージ、訓練済みモデルを組み合わせる必要があり、最も高度な深層学習アルゴリズムの多くはPythonで書かれています。
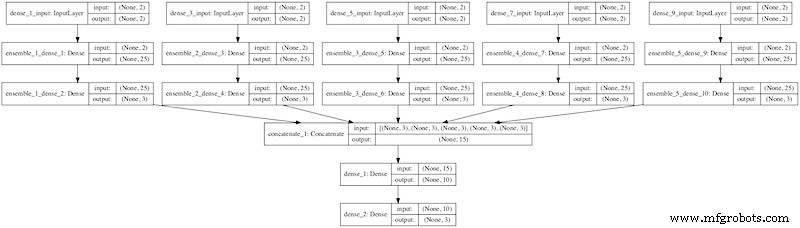
図2. Pythonによる深層学習ニューラルネットワークのスタッキングアンサンブル。画像提供:Machine Learning Mastery
Pythonとそれぞれの深層学習ツールを知っていることは、異なるモデルを組み合わせる前提条件です。それらが整ったら、異なる深層学習アルゴリズムを組み合わせるためのさまざまな技法が実装されます。以下のセクションで説明します。
(重み付き)平均法
この手法では、2つのモデルの平均を新しいモデルとして使用します。これは2つの深層学習モデルを組み合わせる最も直接的な方法です。2つのモデルの単純平均を取って作成されたモデルは、元の2つのモデルより高い精度を持ちます。
結合モデルの精度と結果をさらに向上させるため、重み付き平均は有効な選択肢です。異なるモデルに与える重みは、モデルの性能や各モデルが受けた訓練量に基づくことができます。この手法では、2つの異なるモデルを組み合わせて新しいモデルを形成します。
バギング法
同じ深層学習モデルでも複数のイテレーション(反復)を持つことができます。異なるイテレーションは異なるデータセットで訓練され、異なるレベルの改善を持ちます。同じ深層学習モデルの異なるバージョンを組み合わせるのがバギング法です。
方法論は平均法と同じです。同じ深層学習モデルの異なるバージョンを、単純平均または重み付き平均の形で組み合わせます。この手法は、単一モデルに蓄積された確証バイアスを持たない新しいモデルを作成するのに役立ち、モデルをより正確で高性能にします。
ブースティング法
ブースティング法は、モデルにフィードバックループを使用するのと似ています。あるモデルの性能を用いて後続のモデルを調整します。これにより、モデルの成功に寄与するすべての要因を蓄積する正のフィードバックループが生まれます。
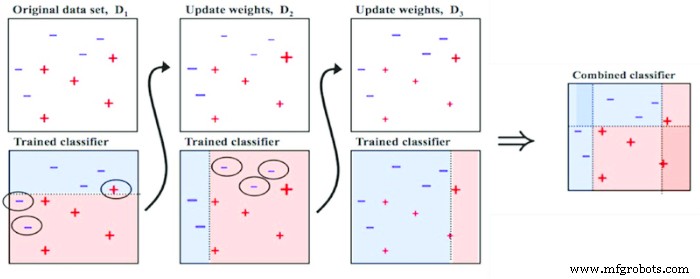
図3. アンサンブル学習のブースティング法。画像提供:Ashish Patel
ブースティング法は、モデルが経験するバイアスと分散を低減します。これは、それらの負の側面が後続のイテレーションでフィルタリングされるため可能です。ブースティングは、重みベースのブースティングと残差ベースのブースティングの2つの異なる方法で実行できます。
連結法
この手法は、異なるデータソースを同じモデルに統合する際に使用されます。この結合技術は、異なる入力を取り込み、それらを同じモデルに連結します。結果として得られるデータセットは、元のデータセットより多くの次元を持ちます。
これを順次複数回行うと、データの次元が非常に大きな数に成長し、過学習と重要な情報の喪失を招き、結合モデルの性能を低下させる可能性があります。
スタッキング法
深層学習モデルのスタッキング法は、前回のイテレーションの性能を用いて前のモデルをブーストすることで、深層学習モデルを開発するためのさまざまな手法を統合します。このスタックされたモデルに重み付き平均の要素を追加することで、サブモデルへの正の貢献が改善されます。
同様に、バギング技法と連結技法をモデルに追加できます。モデルを組み合わせるさまざまな技法を組み合わせることで、結合モデルの性能を向上させられます。
深層学習モデルを組み合わせるために使用できる方法論、技法、アルゴリズムは無数にあり、常に進化しています。同じタスクを達成する新しい技法が登場し、より良い結果を提供し続けるでしょう。モデルの組み合わせについて知っておくべき重要なポイントを以下にまとめます。
- 深層学習モデルの組み合わせはアンサンブル学習とも呼ばれる
- 異なるモデルの組み合わせは、深層学習モデルの性能向上のために行われる
- 組み合わせによる新しいモデル構築には、時間、データ、計算リソースが少なくて済む
- モデルを組み合わせる最も一般的な方法は複数モデルの平均化であり、重み付き平均を取ると精度が向上する
- バギング、ブースティング、連結は深層学習モデルを組み合わせる他の方法
- スタックド・アンサンブル学習は、異なる結合技法を使用してモデルを構築する
モノのインターネットテクノロジー
- ディープラーニング:インテリジェントオートメーションで産業を変革
- ディープラーニングがライフサイエンスの検査自動化に革命をもたらす
- SPICEダイオードモデリング:正確なシミュレーションのための実践ガイド
- 50Ω同軸ケーブルがDCではなくACでテストすると50Ωのように振る舞う理由
- 機械学習モデルが電池の健康状態と寿命を高精度で予測
- AI、機械学習、ディープラーニングの違いを徹底解説
- ICP Mustang-F100:リアルタイム ディープラーニング推論向けFPGAアクセラレーター
- 工場現場におけるAIの着実な台頭
- 医療分野におけるAI・深層学習のアウトソーシング:データプライバシーの保護
- 産業用IoTバリューチェーン:デバイスデータからビジネスROIへ
- HPE、ML Opsプラットフォームを発表しAIモデル開発を加速