



データサイエンス入門:核心概念、種類、キャリア機会
データサイエンスとは?
データサイエンスは、科学的手法、プロセス、システムを用いて、構造化・非構造化データを収集、準備、分析する学際的な分野です。数学、統計学、データベース、情報科学、計算機科学など多様な分野を活用します。データは多様なタイプとサイズで存在します。
データサイエンスが独立した分野として必要とされる理由:
主な理由は、私たちを取り巻くデータが指数関数的に増加していることです。推計によれば、2020年までに1秒あたり約1.7メガバイトのデータが生成され、デジタルデータの総量は44兆ギガバイトに達するとされています。このような膨大なデータを理解し、保存することはますます困難になっています。したがって、このデータを研究し、意味をなす方法が必要となり、データサイエンスが独立した分野として認識されるようになりました。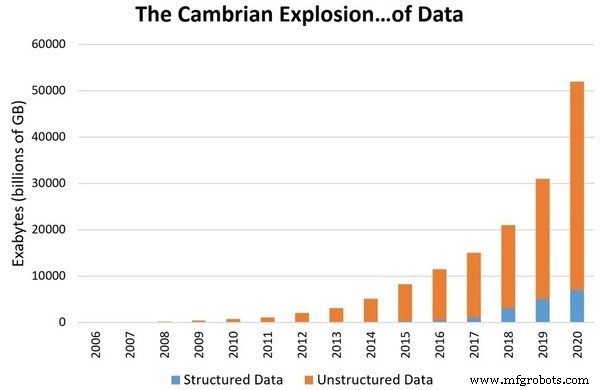
身近なデータサイエンス:
企業はデータサイエンスを用いて、社内のデータプロセスを理解し、容易に整理しています。例えば、Googleはデータサイエンスを活用し、ユーザーが利用するウェブサイト上に表示される広告をパーソナライズしています。これは、パブリッシャーがターゲットオーディエンスにコンテンツを配信できるAdSenseプログラムを通じて行われています。
同様に、Uberは顧客への請求額、割引のタイミングと対象を計算します。Airbnbはデータサイエンスを用いて、宿泊料金の目安を提示します。簡単に言えば、顧客やユーザーを生データと見なし、データサイエンスがそのデータを解釈するのを助けます。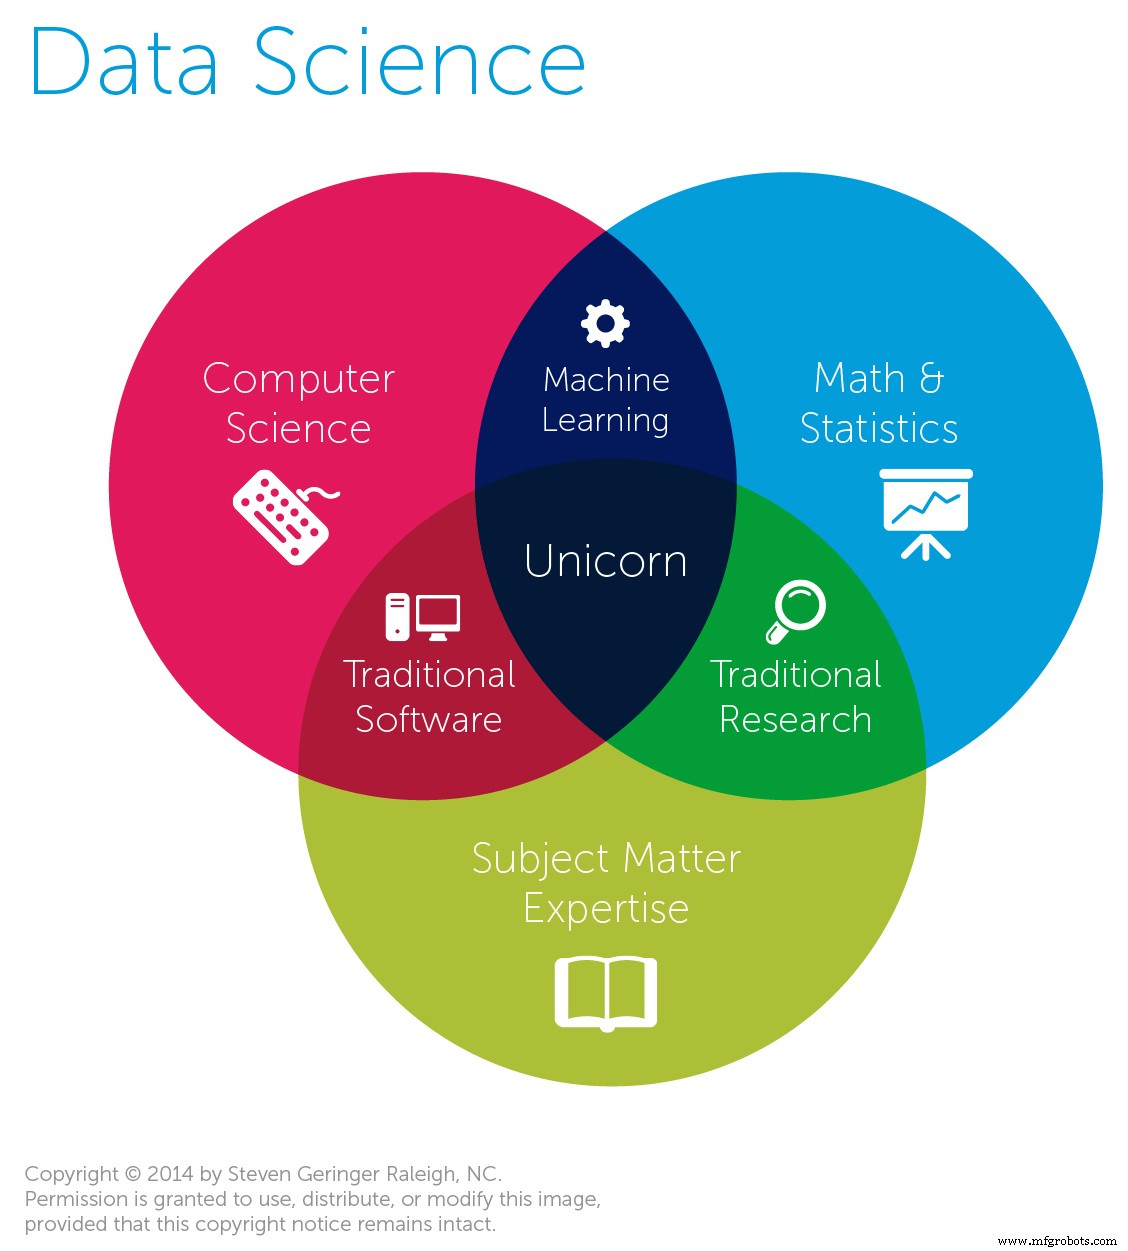
政府・非政府組織におけるデータサイエンス:
データは政府組織にとって重要な資産です。毎日増大するデータを整理・保存する方法が必要であり、それはデータサイエンスで実現できます。同様に、非政府組織もデータサイエンスを活用しています。WWF(世界自然保護基金)は、野生生物に関する問題を統計的に示し、その活動を効果的にするためにデータサイエンスを利用しています。
データサイエンスの機会:
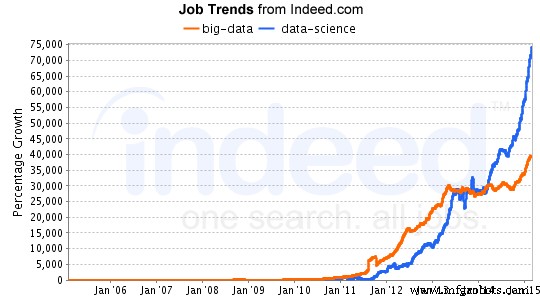
データサイエンス分野の成長に伴い、この分野の雇用機会も指数関数的に増加しています。LinkedInによるデータサイエンス職の成長分析では、過去30年間で特に大きな増加が見られました。データサイエンスに興味があるなら、オンラインで無料コースを受講できます。Common Loungeのチュートリアルをチェックしてみてください。
主要コンポーネント:
ここではデータサイエンスとそのさまざまなコンポーネントについて洞察を提供します。
1. プログラミング:
データサイエンスはデータそのものです。このデータを整理・分析するためにプログラミングを使用します。プログラミング言語は多岐にわたりますが、最も普及しているのはPythonとRです。
Python: 最も読みやすく柔軟なプログラミング言語であり、広く使用されています。NumPy、pandas、Matplotlib、TensorFlow、iPythonなど、強力な統計・数値計算パッケージを多数備えています。Pythonは高速で学習しやすいです。
R: 統計的・グラフィカル手法に焦点を当てた言語です。統計学者やデータマイナーの間で、統計ソフトウェア開発とデータ分析に広く使用されています。オープンソース言語です。
2. データとその種類:
次の主要コンポーネントはデータ自体です。データを理解するには、まずその種類を理解する必要があります。
構造化データ: 高度に組織化された情報を指し、表形式で容易に表現でき、データベースに格納・処理可能です。
非構造化データ: データモデルを持たない、または整理されていない情報です。テキスト、日付、数字、メール、PDFファイル、画像、動画などで構成される場合があります。
自然言語: 英語、スペイン語、ウルドゥー語など、コミュニケーションに使用される書き言葉の形をしたデータです。非構造化データの一種と見なせます。
画像、動画、音声: これらも非構造化の形をとります。カメラやマイクで生成され、スマートフォンでの日常的な保存・処理により利用が増えています。
グラフベースデータ: グラフは頂点と辺の集合です。2つのエンティティ間の関係を示す数学的構造です。
機械生成データ: コンピュータシステム、アプリケーション、機械によって人間の関与なしに生成されるデータです。
3. 統計学、確率とデータサイエンスとの関係:
統計学: データの収集、解釈、分析、提示、整理を扱う数学の一分野です。プログラミングを用いてデータを分析します。
確率: 事象が発生する可能性の尺度です。0から1の数値で量化され、0は不可能、1は確実を意味します。
データサイエンスとの関係: 統計学と確率はともにデータサイエンスに関連しています。これらはデータの処理と分析の基盤です。データを正しく解釈するために、これら両方の科学をデータサイエンスと関連付けて使用します。
4. 機械学習:
機械学習はAIから派生した計算機科学の分野です。統計的手法を用いて、明示的にプログラミングせずにコンピュータに学習能力を与えます。機械は、構造やプログラムを変更することで、特定のタスクにおけるパフォーマンスを徐々に向上させます。機械学習には3つの主要な目標があります。1つ目は、変化とその表現を学習すること。2つ目は、単一のタスクだけでなく類似タスクにも有効なよう性能を一般化すること。3つ目は、機械の性能を向上させ、性能低下を防ぐ方法を見つけることです。データサイエンスでは、機械学習はアルゴリズム、回帰、分類手法で使用され、さまざまな方法で処理されるデータから結果を予測するために用いられます。
5. ビッグデータ:
ビッグデータとは、膨大な量のために、保存や処理に多数のコンピュータを必要とするデータの総称です。3つのVで特徴づけられます:
Volume(量): テラバイトからゼッタバイトまでの大量データ。
Variety(多様性): データは多様性を示し、構造化・非構造化など2つ以上のタイプが混在することがあります。
Velocity(速度): データは常に増大する速度で生成されます。本質的にデータのスピードです。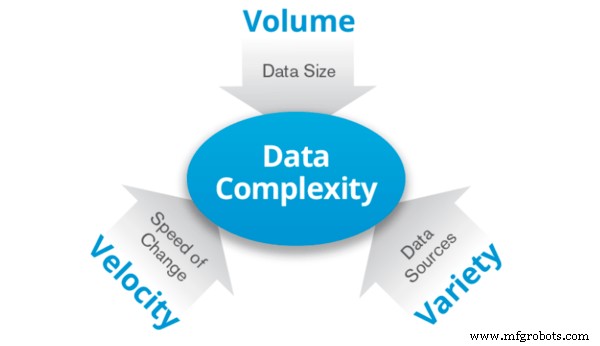
データサイエンスでは、データは多くの形態とタイプに分類されます。ビッグデータは、従来のアプリケーションでは処理できない膨大な量のデータを指すと言えます。データサイエンティストは、Hadoop、Spark、R、Javaなどのさまざまなツールを用いてビッグデータを研究・処理します。
産業技術
- デジタルメモリの基礎:アドレッシング、アクセス、揮発性
- 5つのデータセンターモデルを解説:設計、ユースケース、事例
- 製造プロセスの理解:定義、種類、主要構成要素
- フライス盤の種類、機能、CNC製造における応用
- エッジコンピューティング解説:輸送、ユーティリティ、製造における実用ユースケース
- 主要な機械加工プロセス:整形、旋削、穴あけ、フライス加工の基礎
- C# 変数とプリミティブデータ型:完全マスターガイド
- C言語のデータ型完全ガイド:整数、浮動小数点、void型
- C#データ型完全ガイド:値型、参照型、ポインタ型
- MATLABデータ型完全ガイド:15種類の基本型と変換・判定関数
- Python データ型マスター: 実践ガイド