



MLCommons、MLPerf Inference Benchmark 2024を発表:エッジ、データセンター、モバイル、ノートブックの結果
MLPerfベンチマークスイートをキュレートする独立組織MLCommonsが、最新のMLPerf Inferenceスコアを発表しました。新しい結果は、データセンター、エッジ、モバイル、ノートブックの4デバイスクラスに明確に分割されており、購入者、ベンダー、研究者が実ワークロード全体で性能を比較しやすくなっています。
デバイスクラス別セグメンテーション
スコアをデバイスクラス別に分離することは、各市場を特徴づける異なるフォームファクタと性能プロファイルを反映しています。MLCommonsエグゼクティブディレクターのDavid Kanter氏はEE Timesに対し、「ノートブックの話ならおそらくWindows、スマートフォンならiOSまたはAndroidが動いているでしょう。モバイルとノートブックの結果を分離することで、各ユースケースに最も関連するアクセラレーターの能力についてより明確な洞察が得られます」と語っています。
最先端モデル
前回が主にビジョンタスクに焦点を当てていたのに対し、今回のベンチマークには5つの現代的で本番グレードのモデルが組み込まれています:
- DLRM – 大規模レコメンデーションエンジン
- 3D-UNet – MRIスキャンでの腫瘍検出用医療画像モデル
- RNN-T – 音声テキスト変換エンジン
- BERT – 自然言語処理トランスフォーマー
- MobileNetEdge、SSD-MobileNetv2、Deeplabv3、Mobile BERT – 上記のモバイル最適化版
これらの選定は、レコメンデーション、医療画像、音声分野の業界専門家を含むアドバイザリーボードによって推進され、ベンチマークが今日の本番環境で最も要求の厳しいワークロードを反映することを保証しています。
データセンター性能
予想通り、NvidiaのGPUがデータセンタークラスを支配しています。実際、総提出の85%がNvidiaハードウェアで動作し、同社は参入したすべてのカテゴリで首位を獲得しました。ベンチマークは拡大する性能ギャップを示しています:基本的なコンピュータビジョンモデルでは、Nvidia A100がIntel Cooper Lake CPUの約30倍のスループットを発揮し、レコメンデーションシステムワークロードでは同等CPUの237倍高速です。NvidiaプロダクトマネジメントシニアディレクターのParesh Kharya氏は、単一のDGX-A100がレコメンデーションタスクで1,000ノードCPUクラスタの性能に匹敵し、スケールメリットが絶大であることを強調しています。
このクラスで唯一の非CPU、非GPUエントリーは、MipsologyのZebraアクセラレーターで、Xilinx Alveo U250 FPGA上で動作します。Zebraはサーバーモードで4,096 ResNetクエリ/秒(Nvidia T4は5,563)、オフラインで5,011サンプル/秒(T4は6,112)を達成しました。
研究開発カテゴリでは、台湾企業NeuchipsのRecAccel(DLRM向けFPGAベースアクセラレーター)がIntel Cooper Lake CPUと同等かそれ以下の性能で、Nvidiaの結果には及ばなかった。これらの初期段階プロトタイプは、商用化されていなくても、新興AIハードウェアの幅広さを示しています。
エッジティアの結果
エッジシステムは主にNvidiaのA100、T4、AGX Xavier、Xavier NXチップで動作していました。Centaur Technologyのリファレンス設計(独自x86プロセッサーと別AIコプロセッサー搭載)は、シングルストリームResNetレイテンシでNvidia Tesla T4を上回りましたが、スループットでは後れを取りました。英国コンサルタントのdividitiは、Raspberry PiからNvidia AGX Xavierまで幅広いスコアを提示し、OS選択とオンチップアクセラレーターの使用が結果にどう影響するかを浮き彫りにしました。
研究開発プールからの新規参入として、ロシア企業IVA Technologiesと韓国スタートアップMobilintが参加。どちらも画期的な性能ではありませんでしたが、プロトタイプアクセラレーターが商用ソリューションとベンチマーク対決するに足るソフトウェア成熟度に達していることを示しています。
モバイルとノートブックのベンチマーク
モバイルクラスでは3つの比較可能な提出がありました:MediaTek Dimensity 820(Xiaomi Redmi 10X 5G)、Qualcomm Snapdragon 865+(Asus ROG Phone 3でテスト)、Samsung Exynos 990(Galaxy Note 20 Ultra使用)。Samsungが画像分類とNLPで首位、MediaTekが物体検出で優秀、Samsungが再び画像セグメンテーションで優位でした。結果は、単一SoCがすべてのタスクで支配するわけではなく、ワークロード固有の最適化の重要性を示しています。
ノートブックカテゴリには、間もなく登場するXe-LP GPUを搭載した単一のIntelリファレンス設計のみが含まれていました。限定的なデータセットでは詳細比較は困難ですが、Xe-LPは画像セグメンテーション(DeeplabV3)で最良モバイルSoCの2.5倍、物体検出(SSD-MobileNetv2)で1.15倍のスループットを達成しました。
今後の展望
Kanter氏はMLCommonsのベンチマークエコシステムにおける多様性へのコミットメントを強調。非Nvidia、非Intel、中小企業の参加を奨励し、任意のネットワークやモデルをテストできるオープン部門を設けています。「次回ラウンドでは電力測定ディメンションの追加にも取り組んでいます」とKanter氏は語り、必要なツール開発へのコミュニティ参加を呼びかけています。
MLPerf Inference結果の完全で詳細なリストは、こちらをクリックしてください。
出典: EE Times
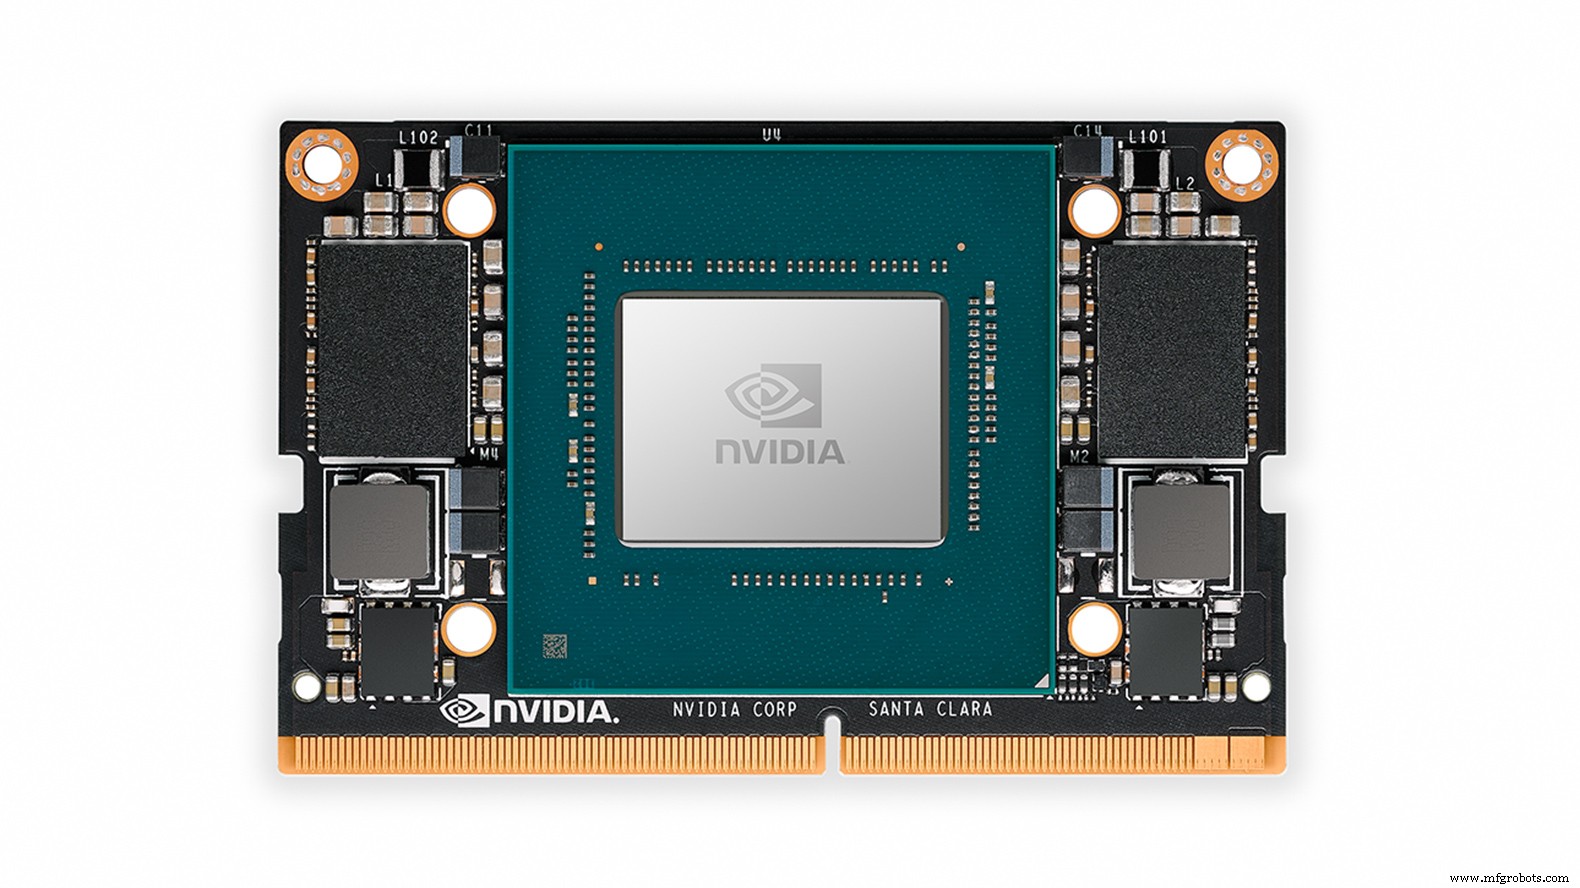
エッジ結果はNvidia GPUが支配、Jetson Xavier NXを含む
埋め込み
- 機械学習でパイプライン安全性を加速:リアルタイム故障検知で1000万ドル節約
- 堅牢なWi-Fiネットワークでエッジコンピューティング効率を飛躍させる
- 縦形マシニングセンタ(VMC)の生産性を飛躍させる7つの先進機能
- ジョンフォード ST-80 CH:油田・エネルギー・建設向け高精度CNC旋削センター
- 精密4軸 VTC 100-4:高性能シャフト旋削機
- STMicroelectronics LSM6DSOX:機械学習搭載慣性センサで精密・省電力アクティビティトラッキング
- ADLINKとCharles Industries、5Gポールマウント導入向け初の完全統合マイクロエッジAI/MLソリューションを発表
- 堅牢なデータ管理が産業IoTにおける機械学習とAIを駆動する
- NXP、eIQツールキットでエッジAIを加速
- エッジAI:処理がデバイス層へシフトする理由
- エッジコンピューティング:クラウド時代の新たな鼓動