



機械学習入門:初心者が押さえるべき4つのコアタイプ
ビッグデータは未来技術の基盤ですが、機械学習(ML)と人工知能(AI)も不可欠な役割を果たします。三者の関係は「ビッグデータ=素材、ML=方法、AI=成果」と捉えられます。
機械学習とは
AIの一分野で、明示的なプログラミングなしに、経験(データ)から自動的に学習・適応・改善するアルゴリズムを構築する技術。MLアルゴリズムは「訓練データ」に基づきモデルを構築し、未知データへの予測・分類を行います。
機械学習の4分類
- 教師あり学習
- 教師なし学習
- 半教師あり学習
- 強化学習
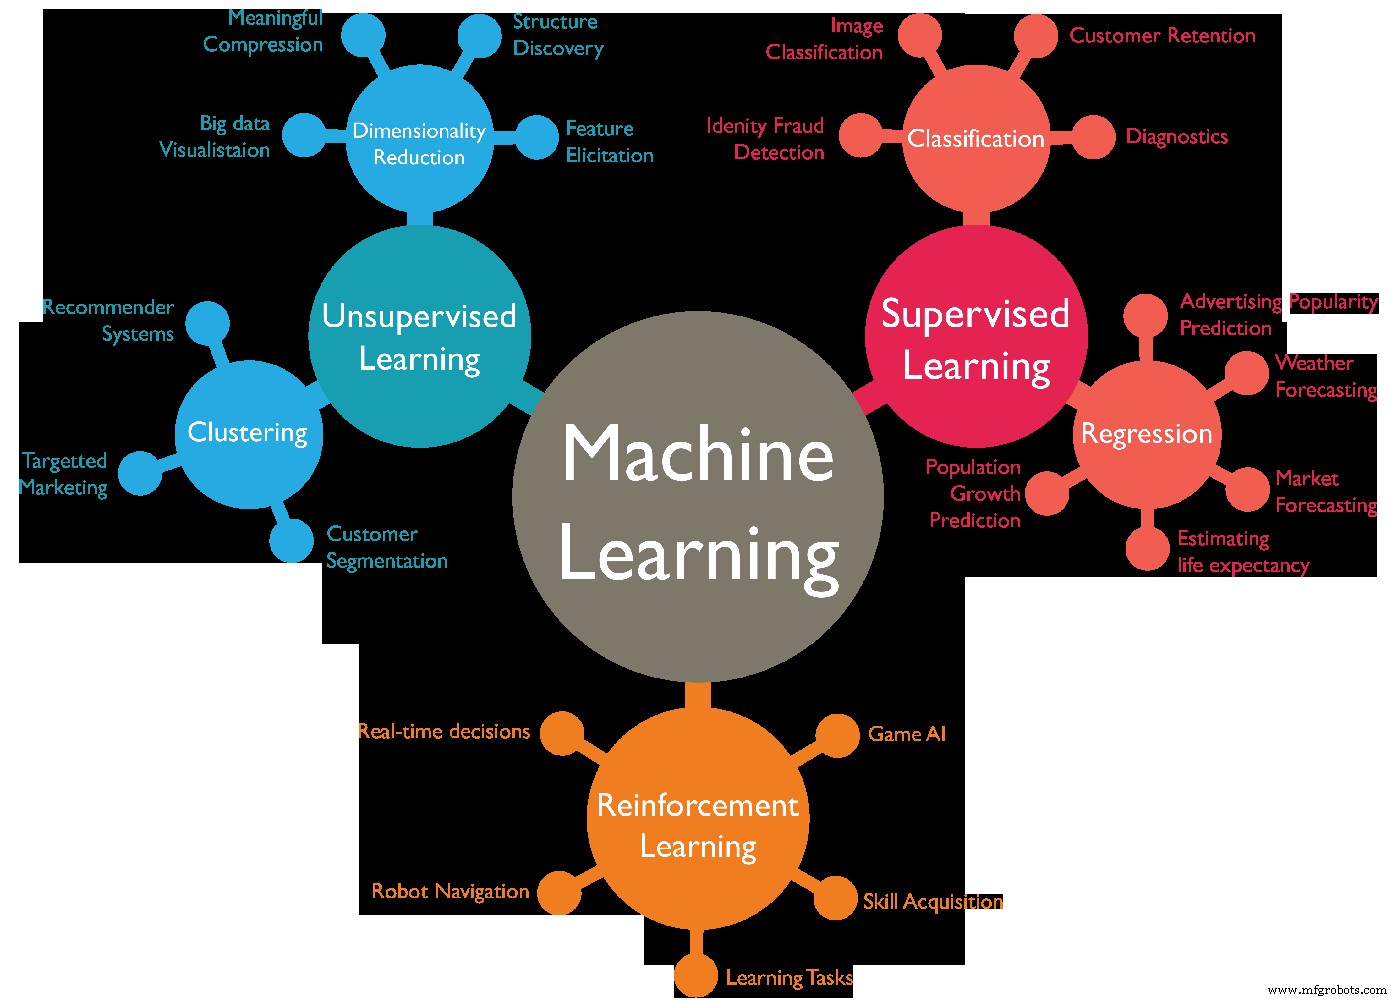
教師あり学習
「正解ラベル付きデータ」でモデルを訓練し、未知データの正解を予測させる手法。過去データ(入力特徴量)と正解(ラベル)のセットを与え、入力から正解を導く関数を学習させます。予測値と正解の差分でモデルを修正します。
最も基本的で、コンピュータにとって易しく、人間にとってラベル付けが大変な手法。例:スパム判定、株価予測、画像分類。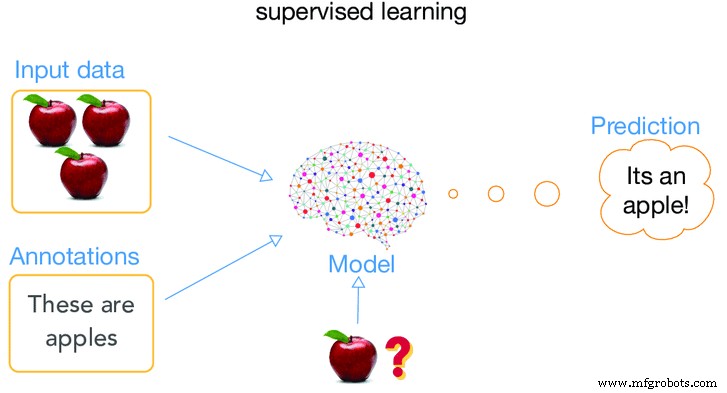
教師なし学習
ラベルなしデータから、データの内在的構造・パターンを自動発見する手法。人間には見えにくい相関やクラスタを機械が見つけ出します。
人間には易しい(ラベル付け不要)が、コンピュータには難しく、誤りも生じやすい。出力は「正解」ではなく「データの隠れた構造の記述」。パターン認識、異常検知、顧客セグメンテーション等に有用。
半教師あり学習
少量のラベル付きデータと大量のラベルなしデータを組み合わせる手法。ラベル付けコスト(専門家工数)が高い現実的な選択肢。ラベル付きデータでベースモデルを作り、それを用いて未ラベルデータを分類・予測し、精度を高めます。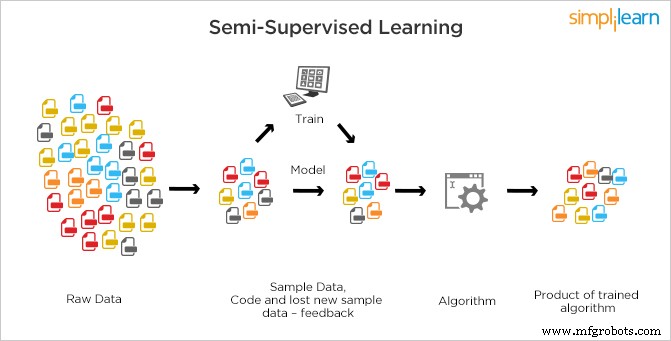
最も実用的で採用例が多い手法。「ラベルなしデータの大半にパラメータ情報が含まれ、少数のラベル付きデータからそれを引き出せる」という考え方に基づきます。
強化学習
人間の試行錯誤学習に最も近い手法。エージェントが環境と相互作用し、行動の結果として報酬(正)やペナルティ(負)を受け取り、累積報酬を最大化する方策を学習します。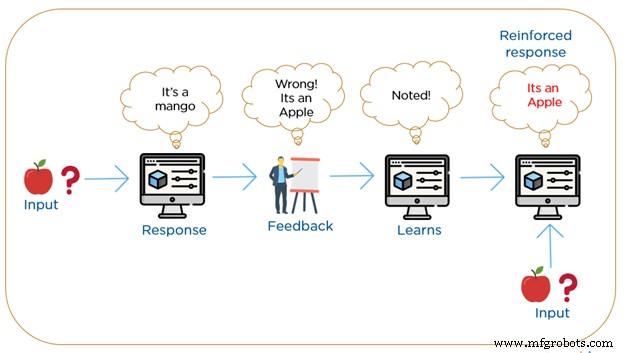
ラベルデータ不要。代わりに「そのステップが良いか悪いか」という単純なフィードバック(強化信号)で学習。フィードバックに基づき分類を逐次修正し、最適解に収束させます。
ビジネス導入は最も難易度が高いですが、自動運転車等で実用化が進んでいます。教師なし学習で一定精度を出すために、強化学習を組み合わせるハイブリッド手法も研究されています。
産業技術
- フライス盤の理解:種類、機能、応用
- Elementary Robotics、シリーズAで1300万ドル調達し産業用機械学習・ビジョンソリューションを拡大
- 機械学習でパイプライン安全性を加速:リアルタイム故障検知で1000万ドル節約
- 機械学習を活用したMROサプライチェーン管理の最適化
- 建設現場の効率を最大化:ライブフィールドデータを活用する4つの質問
- データ分析で石油・ガス資産オーナーの効率と収益性を向上
- ポリウレタン探究:種類・用途・現代産業を支配する理由
- フライス盤を理解する:機能、用途、メリット
- KepwareとMachineMetrics:産業機械データ収集の最適プラットフォーム選び
- 知っておくべき機械学習の必須アプリケーション9選
- AWSがAIと機械学習サービスを新機能と統合で強化