



IBM、新型低精度AIチップで25.6 TFLOPS学習・102.4 TOPS推論を達成
2024年ISSCCにおいて、IBM Researchが低精度AI学習と推論に関する数年の取り組みを具現化した7nmプロトタイプを発表しました。このチップは16ビットと8ビット学習、さらには4ビットと2ビット推論をサポートし、業界標準の32ビット学習/8ビット推論を大きく下回ります。
数値精度を下げることで計算と電力要件を削減できますが、IBMはいくつかのアーキテクチャ最適化も導入し、効率をさらに向上させました。鍵となる課題は、精度を損なわずに精度を下げること──IBMはアルゴリズムレベルから長年取り組んできた問題です。
2019年発足のIBM AI Hardware Centerは、AI計算性能を年率2.5倍向上させ、2029年までにFLOPS/Wで1000倍改善を目指しています。この野心的目標は、特に数兆パラメータNLPシステムのようなAIモデルの爆発的成長と、その学習に伴う炭素フットプリント増大によって駆動されています。
プロトタイプでは、4コアチップが1.6GHz・0.75Vで8ビット学習25.6 TFLOPS、4ビット整数推論102.4 TOPSを達成。クロックを1GHz、電圧を0.55Vに下げると、電力効率は3.5 TFLOPS/W(FP8)または16.5 TOPS/W(INT4)に改善します。
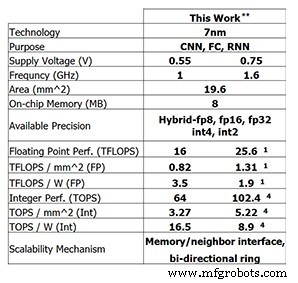
IBM Researchテストチップの性能(画像:IBM Research)** 0%スパース性での報告性能。(1)FP8.(4)INT4.
低精度学習
この性能は、低精度学習と推論技術に関する数年のアルゴリズム作業の上に成り立っています。このチップは、NeurIPS 2019で発表されたIBMのハイブリッドFP8フォーマットをサポートする最初のチップで、16ビット学習の半分の計算量で8ビット学習を可能にし、結果を損なわずに実現します。
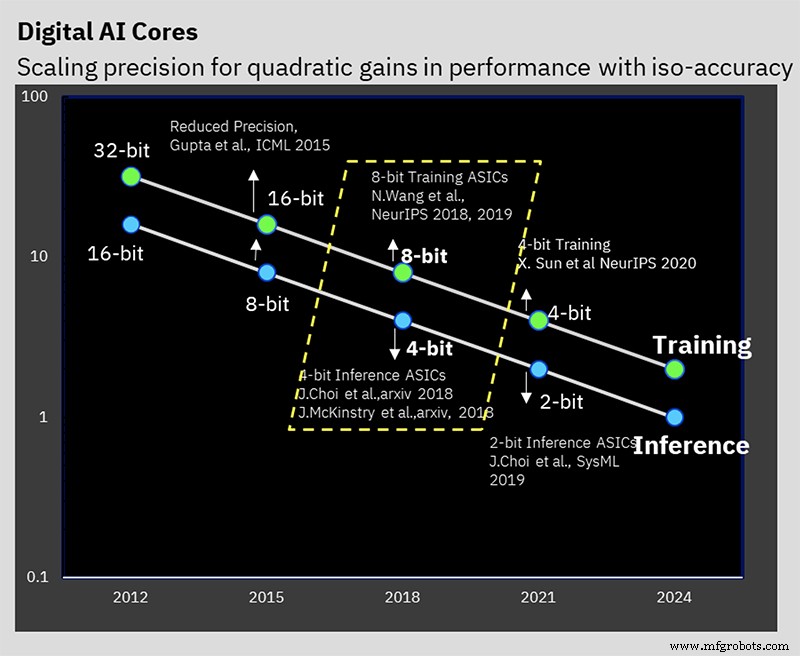
IBM Researchが精度を維持しながら精度を下げる問題に取り組んできた様子(画像:IBM)
「低精度学習は挑戦的ですが、適切な数値フォーマットがあれば8ビット学習は達成可能です」と、IBM Fellowでアクセラレータアーキテクチャと機械学習のシニアマネージャー、Kailash Gopalakrishnan氏。「正しい数値フォーマットを正しいテンソルに適用することが極めて重要です。」
ハイブリッドFP8は2つのフォーマットを組み合わせます:順伝播での重みと活性化用、逆伝播での勾配用。学習には両パスが必要ですが、推論は順伝播フォーマットのみを使用します。
「順伝播テンソルは高い忠実度──仮数部の更なる精度──を必要とし、勾配はより広い動的範囲、より大きな指数部を要求することがわかりました。このトレードオフにより、順伝播で1-4-3(符号-指数-仮数)分割、逆伝播で5ビット指数部、動的範囲232を実現。ハードウェアは両バリアントをサポートします。」
階層的累積
IBMの「階層的累積」技術は、重みと活性化とともに累積時の精度を削減。従来のFP16学習は精度維持のため32ビット算術で累積しますが、8ビット方式ではFP16で累積。長い累積を小さなチャンクにグループ化し、それらを合計することで、丸め誤差を最小化しながら低精度のメリットを維持します。
「数千の数を順次加算すると精度が劣化します」とGopalakrishnan氏は説明。「累積をチャンク化することで、合計を精度良く保ちながらハードウェアをリーンに保てます。」
低精度推論
ほとんどの推論エンジンがINT8を使用する中、IBMは4ビット整数演算で最先端精度に匹敵することを実証。量子化後、量子化対応学習ステップで精度損失を0.5%未満に抑制し、多くのアプリケーションで許容可能なレベルです。
オンチップリング
チップはディープラーニングに最適化されたネットワークオンチップを組み込み、コア間の効率的なマルチキャストデータ転送を実現。オフチップメモリトラフィックと帯域幅要求を削減します。
「リングの動作周波数をコアから分離し、独立した最適化と、長配線レイテンシなしでのより高いコア速度を可能にしました」と、機械学習とアクセラレータアーキテクチャのリサーチスタッフ、Ankur Agrawal氏。
電力管理
IBMは、ワークロード全体でチップを電力エンベロープ近くに保つ周波数スケーリング方式を導入。初期電圧と周波数を積極的に設定することで、計算集約フェーズで高性能を維持し、コストのかかる電圧変更なしで低需要期に適応します。
「ディープラーニングワークロードには明確な電力ピークと谷があります」とAgrawal氏。「我々の戦略は消費電力を安定させ、谷を性能向上に転換します。」
テストチップ
4コア設計は接続複雑性とコアサイズのバランスを取り、スケーラブルなアーキテクチャを提供。IBMはエッジデバイス向け1-2コアチップ、データセンター展開向け32-64コアチップを予見し、すべてFP16、ハイブリッドFP8、INT4、INT2に対応可能です。
「異なるアプリケーション領域は異なる精度とエネルギートレードオフを要求します」とGopalakrishnan氏。「我々の万能ナイフのようなフォーマット群で、効率を損なうことなく各ユースケースをターゲットできます。」
ハードウェアを補完し、IBM Researchは「Deep Tools」コンパイラスタックをリリースし、チップ上で60-90%の利用率を達成。
以前のインタビューによると、このアーキテクチャベースの低精度AIチップは2年以内に市場投入予定です。
>> この記事は姉妹サイトEE Timesで最初に公開されました。
関連コンテンツ:
- モデル縮小で精度維持するAIチップ
- エッジでのAIモデル学習
- エッジAIへの競争
- エッジAIがメモリ技術に挑戦
- 1mW AIをエッジへ押し上げるエンジニアリンググループ
- 小規模タスク向けニューラルネットワーク応用
- AI IC研究が代替アーキテクチャを探索
Embeddedの週刊メールニュースレターを購読して、さらなる組み込み情報を入手してください。
埋め込み
- 人員削減下での保全管理:戦略的アウトソーシングと継続監視
- ロッキーオートメーション、ATCCと提携しミネソタ中部で自動化トレーニング拡大
- CNC工作機械で製造されるトップ10精密部品
- エージェンシー級の精度でマーケティングROIを最大化
- IBM:プロアクティブなEAMソリューションで資産信頼性と安全性を向上
- マーケティングオートメーションでROIを最大化:エージェンシー級の精度を実現
- 精密加工:製造・建設向け優れた油圧システムの構築
- Bluetooth Mesh設計の選択:モジュールかディスクリートデバイスか
- MITブレークスルー: 1.6mm²暗号IDチップ、テラヘルツバック散乱で偽造対策
- 研究者らが「BrakTooth」公開:Bluetooth Classicの16脆弱性、1,400超のESP32デバイスに影響
- IBM Watsonが産業横断でAIイノベーションを推進する仕組み