



IoTデータETL課題を克服してROIを向上
組織は、ETL(抽出、転送、ロード)テクノロジーの専門知識を開発することで、IoTデータを最適化し、そのビジネス価値を迅速かつコスト効率よく導出できます。
IoTの潜在能力はこれまで以上に大きくなっています。IoT対応デバイスへの投資が2021年までに倍増すると予想され、データと分析セグメントで機会が急増している中、主な課題はIoTデータプロジェクトを取り巻く課題を克服し、コストを抑制することです。
組織は、ストリーム処理とデータレイクのようなETL(抽出、転送、ロード)テクノロジーの専門知識を開発することで、IoTデータを最適化し、そのビジネス価値を迅速かつコスト効率よく導出できます。
関連記事: 4 Principles to Enabling a Pristine Data Lake
しかし多くの組織では、これがITボトルネック、長期プロジェクト遅延、データサイエンスの延期を招く可能性があります。結果:予測分析データが運用効率改善とイノベーション促進で重要な役割を果たすはずのIoTプロジェクトが、依然として概念実証の閾値を超えず、間違いなくROIを実証できません。
IoTが直面するETL課題を理解する
以下の図は問題をよりよく理解するのに役立ちます:
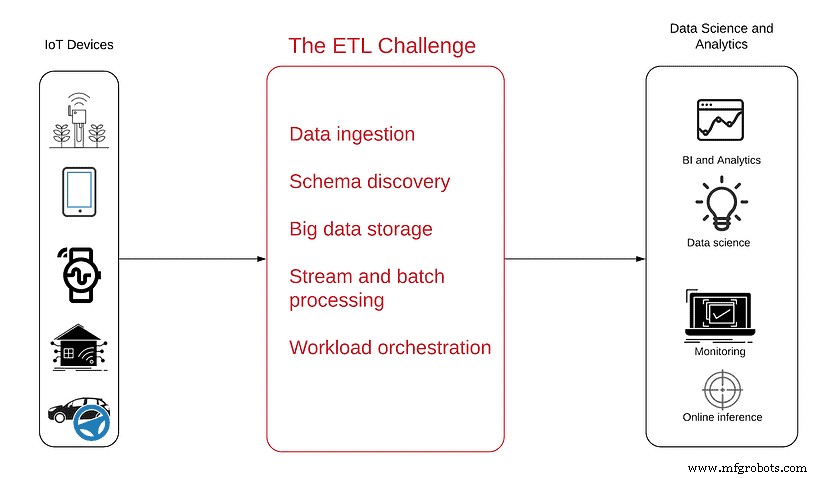
左側がデータソースです ― 単純なアンテナから複雑な自律走行車まで、無数のセンサー搭載デバイスがIoTデータを生成し、半構造化データの途切れないストリームとしてウェブ経由で送信します。
右側は、データ消費が達成すべき目標で、プロジェクトの結論としての分析成果物を含みます:
- ビジネスインテリジェンス 製品使用傾向とパターンへの可視性獲得
- 運用監視 リアルタイムでの停止と非アクティブデバイスの把握
- 異常検知 データの急上昇や急落へのプロアクティブアラート取得
- 組み込み分析 顧客が自分の使用データを見て理解できるようにする
- データサイエンス 予知保全、ルート最適化、AI開発での高度分析と機械学習のメリット享受
これらの目標を達成するには、まずデータを生のストリーミングモードから、SQLや他の分析ツールでクエリ可能な分析対応テーブルに変換する必要があります。
ETLプロセスは、IoTデータが通常のリレーショナルデータベース、ETL、BIツールと常に同期していない一連の独自の特性を持つため、あらゆる分析プロジェクトで最も理解しにくいセグメントであることがよくあります。例えば:
- IoTデータはストリーミングデータです、 小さなファイルで継続的に生成され、巨大で広大なデータセットに蓄積されます。これらは従来の表形式データとは大きく異なり、結合、集約、データエンリッチメントを実行するにより複雑なETLを必要とします。
- IoTデータは今すぐ保存、後で分析。 典型的なデータセットとは異なり、IoTデバイスが生成するデータの膨大な量は、分析前に置き場所が必要です ― クラウドまたはオンプレミスのデータレイク。
- IoTデータは複数デバイスによる順不同イベントを呈示します インターネット接続エリアを行き来する可能性があるため。これはログがさまざまな時間にサーバに到達し、常に「正しい」順序ではないことを意味します。
- IoTデータはしばしば低レイテンシアクセスを必要とします。 運用上、リアルタイムまたはニアリアルタイムで異常や特定デバイスを特定する必要があるため、バッチ処理によるレイテンシを許容できません。
データレイク構築にオープンソースフレームワークを使用すべきか?
エンタープライズデータ分析プラットフォームを構築するため、多くの組織はこの一般的なアプローチを取ります:オープンソースストリーム処理フレームワークをビルディングブロックとして、Apache Spark/Hadoop、Apache Flink、InfluxDBなどの時系列データベースを加えてデータレイクを作成します。
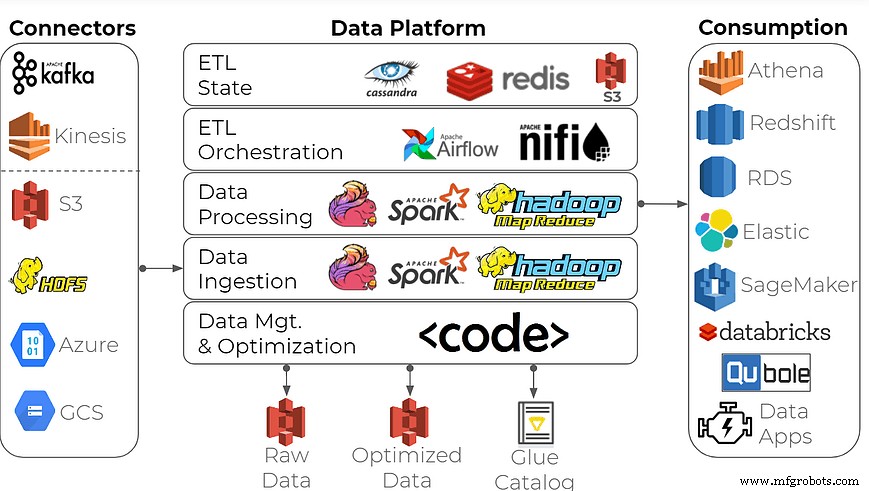
このツールセットで仕事はできますか?確かに。しかし、最もデータ経験豊富な企業を除いて、正しくやるのは圧倒的です。このようなデータプラットフォーム構築には、ビッグデータエンジニアの専門スキルとデータインフラストラクチャへの強い注意が要求されます ― 通常、IoTデータと密接に働く製造業と家電業界の強みではありません。遅延納品、高コスト、大量の浪費されたエンジニアリング時間を覚悟してください。
高性能と機能・ユースケースのフルレンジ ― 運用レポーティング、アドホック分析、機械学習のためのデータ準備 ― を求めるなら、適切なソリューションを採用してください。例として、ストリームを分析対応データセットに変換する目的別のデータレイクETLプラットフォームの使用があります。
このソリューションは、Spark/Hadoopデータプラットフォームほど硬直的で複雑ではありません。Java/Scalaでの激しいコーディングではなく、セルフサービスユーザーインターフェースとSQLで構築されています。アナリスト、データサイエンティスト、プロダクトマネージャー、DevOpsとデータエンジニアリングのデータプロバイダーにとって、真にユーザーフレンドリーなツールになり得ます:
- ITとデータエンジニアリングに頼らず、データ消費者のセルフサービスを提供
- ETLフローとビッグデータストレージを最適化し、インフラコストを削減
- フルマネージドサービスにより、組織がインフラではなく機能に集中できる
- リアルタイムデータ、アドホック分析、レポーティングのための複数システム維持の必要性を排除
- データが顧客のAWSアカウントから出ないことを保証し、完全なセキュリティを確保
適切なツールさえあれば、IoTデータから利益を得られます。
モノのインターネットテクノロジー
- スマート データ:IoTとビッグデータの次なるフロンティアをナビゲート
- IoTをシンプルに:エンタープライズ成功のための相互運用性とセキュリティ
- エッジからクラウドへ:IoTデータパイプラインのマスター
- IoT革命をリードする産業——なぜ勝ち残れるのか
- 緊急のデータ統合:IoTの父からの洞察
- 産業成功のためのIoTデータ準備:トップ3の課題
- IoTとクラウドコンピューティングが形作るエンタープライズデータの未来
- AIoT:人工知能がIoTを増幅する仕組み
- IoTの民主化:次世代衛星IoTがもたらす普遍的で手頃な接続性
- IoTデータの価値を引き出す:セキュアでインサイト主導の戦略
- IoTデータを活用した製造エクセレンスの実現