



Hadoop入門:ビッグデータ処理のための包括的ガイド
ビッグデータの進化は、新たなソリューションを必要とする新たな課題を生み出しました。歴史上かつてないほど、サーバーは膨大な量のデータをリアルタイムで処理・ソート・保存する必要に迫られています。
この課題により、Apache Hadoopのような大規模データセットを容易に扱える新しいプラットフォームが登場しました。
本記事では、Hadoopとは何か、その主要コンポーネント、そしてApache Hadoopがビッグデータ処理にどのように役立つかを解説します。
Hadoopとは
Apache Hadoopソフトウェアライブラリは、分散コンピューティング環境においてビッグデータを効率的に管理・処理するためのオープンソースフレームワークです。
Apache Hadoopは4つの主要モジュールで構成されています:
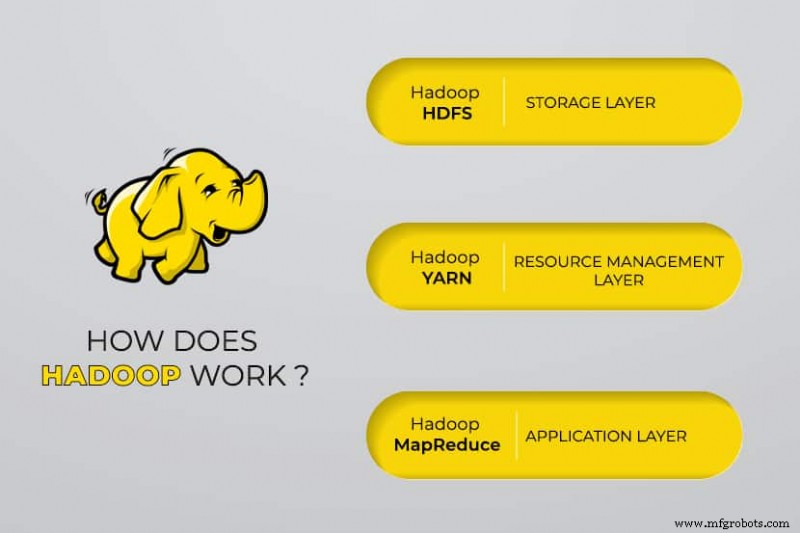
Hadoop Distributed File System(HDFS)
データはHadoopの分散ファイルシステムに格納され、これは一般的なコンピューターのローカルファイルシステムに似ています。HDFSは従来のファイルシステムと比較して、優れたデータスループットを提供します。
さらに、HDFSは優れた拡張性を備えています。単一マシンから数千台まで、コモディティハードウェア上で容易にスケールアウト可能です。
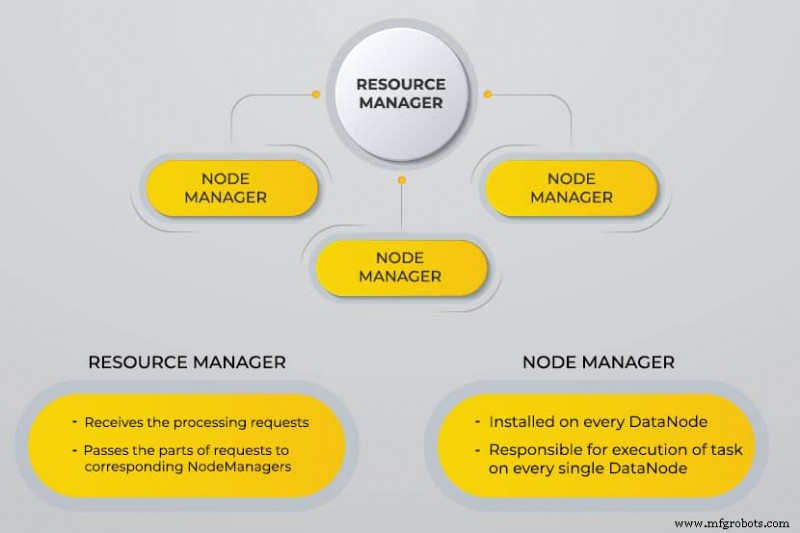
Yet Another Resource Negotiator(YARN)
YARNはスケジュールタスクの調整、クラスターノードとその他リソースの管理・監視を担当します。
MapReduce
Hadoop MapReduceモジュールは、プログラムが並列データ計算を実行するのを支援します。MapReduceのMapタスクは入力データをキー・バリューペアに変換し、Reduceタスクは入力を消費・集約して結果を生成します。
Hadoop Common
Hadoop Commonは、すべてのモジュールで標準的なJavaライブラリを使用します。
なぜHadoopは開発されたのか
ワールドワイドウェブは過去10年間で指数関数的に成長し、現在では数十億ページで構成されています。情報量が膨大になったため、オンラインでの情報検索が困難になりました。このデータがビッグデータとなり、主に2つの問題を抱えています:
- すべてのデータを効率的かつ容易に取得可能な方法で保存することの難しさ
- 保存されたデータを処理することの難しさ
開発者たちは、上記の問題に対処することで、Web検索結果をより速く効率的に返すため、多くのオープンソースプロジェクトに取り組みました。彼らの解決策は、データと計算をサーバークラスターに分散させ、同時処理を実現することでした。
最終的に、Hadoopはこれらの問題の解決策となり、サーバー導入コストの削減など、多くのメリットをもたらしました。
Hadoopビッグデータ処理の仕組み
Hadoopを使用すると、クラスターのストレージと処理能力を活用し、ビッグデータの分散処理を実装できます。本質的に、Hadoopはビッグデータを処理する他のアプリケーションを構築するための基盤を提供します。
さまざまな形式でデータを収集するアプリケーションは、HadoopのAPIを介してHadoopクラスターにデータを格納します。このAPIはNameNodeに接続します。NameNodeはファイルディレクトリの構造と、作成された各ファイルの「チャンク」配置を把握します。HadoopはこれらのチャンクをDataNode間でレプリケートし、並列処理を可能にします。
MapReduceがデータクエリを実行します。すべてのDataNodeをマッピングし、HDFS内のデータに関連するタスクをリデュースします。「MapReduce」という名前自体がその機能を表しています。Mapタスクは指定された入力ファイルに対してすべてのノードで実行され、Reducerはデータをリンクし、最終出力を整理します。
Hadoopビッグデータツール
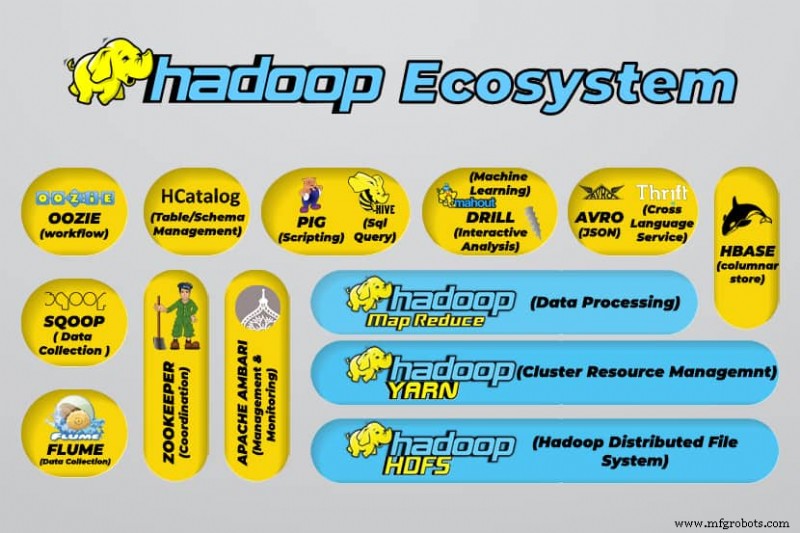
Hadoopのエコシステムは、多様なオープンソースビッグデータツールをサポートしています。これらのツールはHadoopのコアコンポーネントを補完し、ビッグデータ処理能力を強化します。
最も有用なビッグデータ処理ツールには以下が含まれます:
- Apache Hive
Hadoopのファイルシステムに格納された大規模データセットを処理するためのデータウェアハウス。
- Apache Zookeeper
フェイルオーバーを自動化し、障害が発生したNameNodeの影響を軽減します。
- Apache HBase
Hadoop向けのオープンソース非リレーショナルデータベース。
- Apache Flume
大量のログデータをストリーミングするための分散サービス。
- Apache Sqoop
Hadoopとリレーショナルデータベース間でデータを移行するためのコマンドラインツール。
- Apache Pig
Hadoop上で実行されるジョブを開発するためのApacheの開発プラットフォーム。使用言語はPig Latin。
- Apache Oozie
Hadoopジョブの管理を容易にするスケジューリングシステム。
- Apache HCatalog
異なるデータ処理ツールからのデータをソートするためのストレージおよびテーブル管理ツール。
Hadoopの利点
Hadoopはビッグデータ処理のための堅牢なソリューションであり、ビッグデータを扱う企業にとって不可欠なツールです。
Hadoopの主要な機能と利点は以下の通りです:
- 膨大なデータの高速な保存と処理
ソーシャルメディアとIoT(モノのインターネット)の台頭により、保存すべきデータ量は劇的に増加しました。これらのデータセットの保存と処理は、それらを所有するビジネスにとって極めて重要です。 - 柔軟性
Hadoopの柔軟性により、テキスト、記号、画像、動画などの非構造化データタイプを保存できます。RDBMSのような従来のリレーショナルデータベースでは、保存前にデータを処理する必要があります。しかしHadoopでは、データをそのまま保存し、後でどう処理するか決められます。つまり、NoSQLデータベースのように振る舞います。 - 処理能力
Hadoopは分散コンピューティングモデルでビッグデータを処理します。処理能力の効率的な活用により、高速かつ効率的です。 - コスト削減
Hadoopのようなフレームワークが登場する前は、多くのチームが高コストのためにプロジェクトを断念していました。Hadoopはオープンソースフレームワークで無料で使用でき、安価なコモディティハードウェアでデータを保存します。 - 拡張性
クラスター内のノード数を変更するだけで、ほとんど管理作業なしにシステムを迅速にスケールできます。 - 耐障害性
分散データモデルの多くの利点の一つは、障害を許容する能力です。Hadoopは可用性維持のためにハードウェアに依存しません。デバイスが故障すると、システムは自動的にタスクを別のデバイスにリダイレクトします。耐障害性は、クラスター全体にデータの複数コピーを保存することで冗長データを維持することで実現されます。つまり、ソフトウェア層で高可用性が維持されます。
3つの主要ユースケース
ビッグデータの処理
通常ペタバイト以上の膨大なデータ量に対してHadoopを推奨します。莫大な処理能力を必要とする大量データにより適しています。数百ギガバイト程度の少量データを処理する組織には、Hadoopは最適な選択肢とは言えません。
多様なデータの保存
Hadoopの利点の一つは、柔軟性があり多様なデータタイプをサポートしていることです。テキスト、画像、動画データのいずれであっても、Hadoopは効率的に保存できます。組織は要件に応じてデータの処理方法を選択できます。Hadoopはデータレイクの特性を持ち、保存データに対する柔軟性を提供します。
並列データ処理
Hadoopで使用されるMapReduceアルゴリズムは、保存データの並列処理を調整します。つまり、複数のタスクを同時に実行できます。ただし、結合操作は許可されていません。これはHadoopの標準的な手法を混乱させるためです。データが互いに独立している限り、並列性を取り入れています。
実世界でのHadoop活用例
世界中の企業がHadoopビッグデータ処理システムを使用しています。Hadoopの実用的な用途の一部を以下に示します:
- 顧客ニーズの理解
現在、Hadoopは顧客ニーズの理解に非常に役立っています。金融業界やソーシャルメディアの大手企業は、顧客の活動に関するビッグデータを分析することでニーズを把握するためにこの技術を活用しています。企業はそのデータを用いて、顧客にパーソナライズされたオファーを提供しています。これは、私たちの興味やインターネット活動に基づいてソーシャルメディアやECサイトに表示される広告として体験しているかもしれません。 - ビジネスプロセスの最適化
Hadoopは、取引データと顧客データをより適切に分析することで、ビジネスのパフォーマンスを最適化します。トレンド分析と予測分析により、企業は製品と在庫をカスタマイズして売上を伸ばせます。このような分析は、より良い意思決定を促し、より高い利益につながります。さらに、企業は従業員同士の相互作用データを収集し、行動を監視することで職場環境の改善にHadoopを活用しています。 - ヘルスケアサービスの改善
医療業界の機関は、健康問題と治療結果に関する膨大なデータをHadoopで監視できます。研究者はこのデータを分析し、健康問題の特定、薬の予測、治療計画の決定に役立てられます。このような改善により、各国は医療サービスを迅速に向上させられます。 - 金融取引
Hadoopは、事前設定された条件で市場データをスキャンし、取引機会と季節トレンドを特定する高度なアルゴリズムを備えています。金融企業は、Hadoopの強力な機能を通じてこれらの操作の大部分を自動化できます。 - IoTでのHadoop活用
IoTデバイスは、効率的に機能するためにデータの可用性に依存しています。製造業者と発明家は、数十億のトランザクションのデータウェアハウスとしてHadoopを使用しています。IoTはデータストリーミングの概念であるため、Hadoopはそれが包含する膨大なデータを管理するのに適した実用的なソリューションです。Hadoopは継続的に更新され、IoTプラットフォームで使用される命令の改善を可能にしています。
Hadoopのその他の実用的用途には、デバイスパフォーマンスの向上、個人の定量化とパフォーマンス最適化の改善、スポーツおよび科学研究の改善などがあります。
Hadoopを使用する際の課題
すべてのアプリケーションには利点と課題の両方があります。Hadoopにもいくつかの課題があります:
- MapReduceアルゴリズムが万能ではない
MapReduceアルゴリズムはすべてのシナリオをサポートしているわけではありません。単純な情報リクエストや、独立した単位に分割可能な問題には適していますが、反復的なタスクには不向きです。MapReduceは、反復アルゴリズムが集中的なプロセス間通信を必要とし、MapReduceフェーズで複数のファイルを作成するため、高度な分析計算には非効率です。 - 完全なデータ管理ツールの不足
Hadoopは、データ管理、メタデータ、データガバナンスのための包括的なツールを提供していません。さらに、データ標準化と品質判定に必要なツールも不足しています。 - 人材ギャップ
Hadoopの学習曲線が急峻なため、MapReduceで生産的に働くのに十分なJavaスキルを持つエントリーレベルのプログラマーを見つけるのは困難です。この難しさが、プロバイダーがHadoopの上にリレーショナル(SQL)データベース技術を載せることに関心を持つ主な理由です。SQLの確かな知識を持つプログラマーを見つける方が、MapReduceスキルを持つ人材を見つけるよりも容易だからです。Hadoop管理は芸術でも科学でもあり、OS、ハードウェア、Hadoopカーネル設定の低レベルな知識が必要です。 - データセキュリティ
Kerberos認証プロトコルは、Hadoop環境を安全にするための重要な一歩です。データセキュリティは、断片化されたデータセキュリティ問題からビッグデータシステムを守るために不可欠です。
結論
Hadoopは、課題を克服するために必要な手順を踏んで効果的に実装すれば、ビッグデータ処理に非常に有効です。膨大なデータを扱う企業にとって、汎用性の高いツールです。
その主な利点の一つは、あらゆるハードウェアで実行でき、Hadoopクラスターを数千台のサーバーに分散できることです。このような柔軟性は、Infrastructure-as-Code環境において特に重要です。
クラウドコンピューティング
- DDR5 RAM完全解説:特徴、メリット、登場時期
- 産業用IoT(IIoT):定義、範囲、産業への影響
- ビッグデータとAI:デジタルトランスフォーメーションを支える相乗効果
- ビッグデータが公益事業におけるイノベーションと効率を推進
- 製造現場のスモールデータをビッグデータ洞察に変える
- ビッグデータとクラウドコンピューティングの融合:戦略的優位性
- クラウドセキュリティ理解:なぜあなたのビジネスに必要か
- ビッグデータとクラウドコンピューティング:相互補完的な関係性
- ビッグデータとクラウドコンピューティングを活用したビジネス成長の促進
- 2018年のIoTプラットフォーム新興トレンド:エッジコンピューティング、ブロックチェーン、その他
- 予知保全:データ駆動型インサイトで効率化とリスク低減を実現