



CPU-FPGA協調設計を加速:ソフトウェア開発者向け実践的フロー
最近、Brian Baileyが主催したラウンドテーブルが、二部構成の記事Supporting CPUs + FPGAsとして結実しました。専門家たちが、FPGAとCPUを融合したシステムの進化する現実を討議し、いかに新しい設計フローがソフトウェア開発者にCPU+FPGAプラットフォームの迅速な市場投入を可能にするかを浮き彫りにしました。
はじめに
人工知能の急増、コネクテッドデバイスの爆発的増加、データセンターワークロードの加速は、すべて共通のドライバーを指し示しています:速度を求めるソフトウェア開発者の存在です。FPGAとCPU間の低レイテンシリンク、および最新FPGAの控えめな電力エンベロープにより、ハイブリッドCPU-FPGAシステムは要求の厳しい性能ニーズに自然な選択肢となります。しかし、FPGA技術の根本的な複雑さが開発者の足を引っ張ることもしばしばです。
ハイレベル合成(HLS)ツールは大きく進歩し、C/C++からハードウェアへのマッピングを容易にしました。それでも、これらは主にIP中心であり、ソフトウェアとハードウェアのタスク分担、パイプラインか並列実行かの選択、データ粒度の調整、最適な通信メカニズムの選択といったシステムレベルの意思決定には不十分です。
ソフトウェアエンジニアに必要なのは、標準的なソフトウェアIDEのように感じられながら、ハードウェア認識のフィードバックを提供する統一設計フローです。最近の商用ソリューションは、低レベル詳細を抽象化しつつ開発者が求める制御を維持することで、このギャップを埋め始めています。これらのツールは、ESL Models and Their Applicationで概説されているシステムレベル設計哲学に基づいています。
システムレベル設計フローの理解
システムレベル設計は、より高い抽象度で動作し、実装前にシステムコンポーネントを検証、洗練、統合します。ほとんどの設計者はアルゴリズムレベルから始め、C/C++/SystemC、MATLAB、Simulink、LabVIEWなどでフルシステムの振る舞いをモデル化します。
ここではC/C++中心のフローに焦点を当てます(図1参照)。第1段階のアプリケーションプロファイリングで、ハードウェアアクセラレーションの恩恵を受けそうな関数やループを特定します。次に、ターゲットCPU/FPGAプラットフォーム(例:ARM Cortex-A53 + FPGA)を指定し、そのパラメータ(クロック、キャッシュ、インターコネクト)を設定します。最後に、プロファイリングされたタスクをソフトウェアとハードウェアにマッピングし、実行可能なアーキテクチャへと集約します。
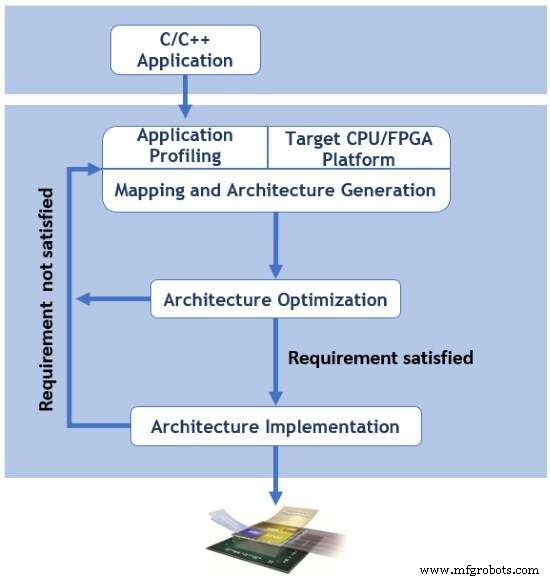
図1. CPU/FPGA向け典型的システムレベル設計フロー(出典: Space Codesign Systems, Inc.)
図1の第2ブロックはアーキテクチャ最適化(アーキテクチャ探索や性能検証とも呼ばれる)を扱い、図2でより詳細に示されています。
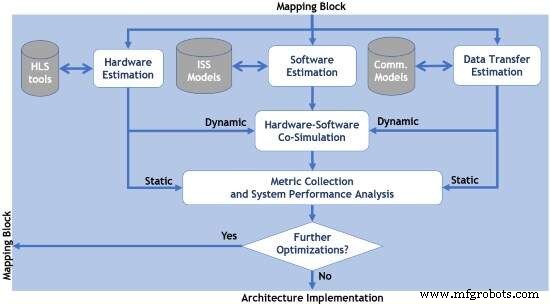
図2. アーキテクチャ最適化プロセス(出典: Space Codesign Systems, Inc.)
この段階に入力する3つの主要な推定器があります。
- ハードウェア推定:C/C++コードをFPGAへ移す影響を評価し、リソース使用量、ループレイテンシ、消費電力を分解。HLS出力に依存。
- ソフトウェア推定:CPU側の指標(プロセッサ負荷、タスク切り替え、キャッシュミス)を測定し、ハードウェア視点を補完。
- データ転送推定:インターフェース(メモリマップドまたはストリーミング)をモデル化し、バスレイテンシ、スループット、キューデプス、メモリフットプリントを把握。
集約結果がデータベースに蓄積され、開発者はシステムレベル目標の達成可否を検証できます。基準を満たすアーキテクチャは次段階へ進み、満たさない場合はさらなる最適化イテレーションがトリガーされます。
図1の最終ブロックはアーキテクチャ実装です:ハイレベル設計が、Xilinx VivadoやIntel Quartus Primeなどのベンダーツールを用いてFPGAビットストリームへ変換され、完全に合成・テスト済みのシステムとしてデプロイ準備が整います。
システムレベル最適化
自動化されたエンドツーエンド最適化ツールの不在は、FPGAベースコンピューティングにおける長年のボトルネックでした。複数の設計次元をバランスさせる複雑さは、熟練設計者であっても手動探索を煩雑にします。
図3は、Zynq-7000プラットフォーム上に6つのC/C++関数で構成される画像処理アプリケーションの典型的な最適化ワークフローを示します。8つの候補アーキテクチャが検討されますが、タイムツーマーケット制約の下で、性能、面積、電力の最良のトレードオフを迅速に選択する必要があります。
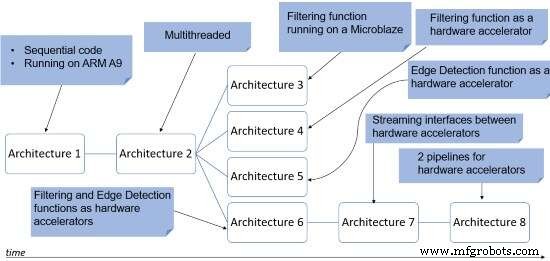
図3. システムレベル決定をハイライトしたアーキテクチャ探索(出典: Space Codesign Systems, Inc.)
XilinxのSDSoC/SDAccel、Falcon ComputingのMerlin Compiler、Space CodesignのSpaceStudioなどの商用ソリューションが、エンドツーエンドサポートを提供し始めています。これらは図1と2のフローを反映しつつ、自動意思決定ロジックを注入します。
- SDSoC:ハードウェアカーネルのレイテンシを推定し、ターゲットプラットフォーム上のデータ転送を特性評価し、純ソフトウェア実行とベンチマーク比較。
- Merlin Compiler:4つのプラグマによるソースツーソース変換と、パイプライン化と並列化を促進する暗黙のコンパイラパスを適用。
- SpaceStudio:ハードウェア生成レイテンシを統合し、ソフトウェアとハードウェア両タスクの非侵襲的プロファイリングを提供するバーチャルプラットフォーム(VP)を構築し、システム全体をシミュレート。
商用エコシステムの俯瞰
図4は、CPU/FPGAプラットフォーム設計を取り巻くエコシステムの階層ビューを示します。最上層にアルゴリズムエントリポイント、中層にC/C++からシステムレベル最適化を支援するツール、最下層にビットストリームを生成するベンダー合成ツールが配置され、ベースには代表的なCPU/FPGAプラットフォームが示されています。
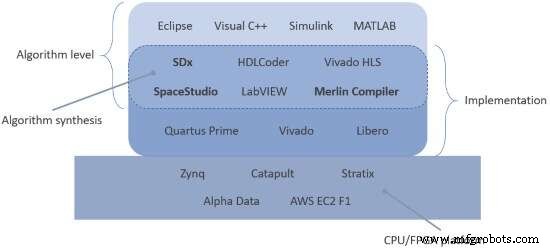
図4. CPU/FPGAプラットフォームの商用エコシステム(出典: Space Codesign Systems, Inc.)
表1に、CPU/FPGAプラットフォーム設計で用いられる主要な商用自動化ツールを一覧します。
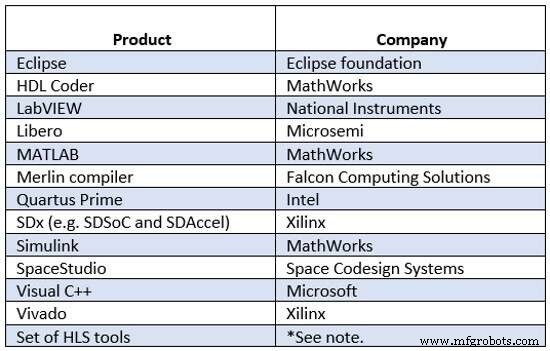
表1. 商用自動化ツール(※本レビューで提案されるリスト)
結論
CPU+FPGA開発の民主化が究極の目標であり、より広範なソフトウェア開発者がハードウェアアクセラレーションを活用できるようにすることです。ソフトウェア業界が50年かけてアセンブリからPythonやSwiftへ進化したように、FPGAプログラミングも同様の成熟過程にあります。SpaceStudio、SDSoC、Merlin Compilerのようなシステムレベルツールの台頭は画期的なシフトを示唆していますが、コンパイラ間の完全自動化とシームレスな最適化は今後のマイルストーンです。
Guy Bois, Ing., PhDはSpace Codesign Systemsの創設者であり、モントリオール工科大学ソフトウェア・コンピュータ工学科教授。STMicroelectronics、Grass Valley、PMC Sierra、Design Workshops Technologies、Cadabra Systemsなど業界リーダーとの豊富なR&D経験を持ち、ハードウェア/ソフトウェア協調設計の専門知識がSpaceStudioの商用化とSpace Codesign Systems Inc.の設立につながりました。
埋め込み
- AMendate CEO Thomas Reiher氏:自動化トポロジー最適化で3Dプリンティングを革新
- AltairのRavi Kunju氏が語る:シミュレーション駆動設計と3Dプリント向け新Inspire Print3D
- 低コストロボットプラットフォームを第7軸ハードウェアと無料デジタルツインプログラミングソフトで強化
- オムロン、「Flow Core」発表──モバイルロボットの信頼性と柔軟性を高める先進ソフトウェア
- 新しい製造ランドスケープをナビゲート:成功への戦略
- VE-VIDESイニシアチブ、IoTセキュリティ向け信頼できる設計・検証フレームワークを発表
- Cadence、ML駆動Cerebrusツールでチップ設計生産性10倍・PPA 20%向上
- MIPIカメラ対応の高性能FPGAアクセラレーターで組み込みビジョンをエッジ処理
- CadenceとUMC、28HPC+ AMS設計フローを認定:自動車/IoT/AIチップ開発を加速
- ボッシュ・ドット・アイオーCEOステファン・ファーバーに聞く5つの質問
- InfineonとElektrobit、コネクテッドカー向け次世代セキュリティを提供