



データレイク vs データウェアハウス:モダンデータエステートの構築
2021年7月27日
出典:MCA Connect | Manufacturing Tomorrow
データは速く、多様な形でやって来る。これらの形には構造化、半構造化、非構造化データが含まれ、データウェアハウスとデータレイクがデータを異なる方法で扱うことを多くの人は認識していない。
モダンなデータエステートは、ビジネスが生成する多様なデータを取り込み、保存する複数の方法を提供すべきだ。データは速く、多様な形でやって来る。構造化、半構造化、非構造化データが含まれ、データウェアハウスとデータレイクがデータを異なる方法で扱うことを多くの人は認識していない。これらのデータタイプをさらに見てみよう:
- 構造化──ERPやCRMシステムのトランザクションデータベースなど、正式なカラムとテーブル定義を持つ伝統的データベース
- 半構造化──要素と階層のタグを持つ自己記述的なXMLやJSONなどのファイル
- 非構造化──画像、動画、音声、その他バイナリデータ
伝統的なデータウェアハウス設計は数十年存在するが、データレイクという概念、あるいは少なくともその用語は比較的新しい構造だ。それぞれが組織のデータエステートに場所を持つ。
データウェアハウス
前述の通り、データソースは非常に多様で異なるデータ表現を持ち、発散した情報につながる可能性がある。また、データソースの多様なスキーマと構造により、すべてのビジネスサブシステムから完全なデータスナップショットを取得する際、統合情報を得るのが困難だ。一般的に、これがデータウェアハウスソリューション出現の主な理由だ。
データウェアハウスは、正式なETL(Extract-Transform-Load)プロセスを実装し、生の構造化データセットを消費し、レポート用に設計されたモデルにロードする、設計ガイドラインに基づく正式な設計だ。データウェアハウスはAzure Synapse(旧Microsoft SQL Server)などのリレーショナルデータベース上に構築される。Azure Synapseは構造化データを従来の行と列のテーブルに格納するよう設計されているが、XMLやJSONなどの半構造化データの格納機能も持つ。
データレイク
データレイクはETLの概念をひっくり返し、ELT(Extract-Load-Transform)プロセスを実装する。データレイクへのデータ取り込みは、将来的に価値があると考えられるすべてを、データタイプや構造に関わらず大容量ストレージエリアに投げ込むことだ。データレイクは構造化、半構造化、非構造化データを格納できる。Microsoft Azureで提供されるデータレイクは、ストレージアカウント作成時にData Lake Storage Gen2を有効化したストレージアカウント上に構築される。
データレイクの背景にある考えは、すべてのデータを取り込み、後で仕分けすることだ。一方データウェアハウスは、多額の先行投資をかけて取り込みを開発し、価値を事前に特定する必要がある。データウェアハウス開発に通常必要な多額の先行投資のため、後で当初取り込まれていなかったデータが必要と判明した場合、ソースデータがもはや利用できず、永遠に失われるリスクがある。
目的:未定 vs 使用中
データレイク内の個々のデータピースの目的は固定されていない。生データがデータレイクに流れ込むとき、特定の将来用途を念頭に置くこともあれば、単に手元に置いておくだけのこともある。つまりデータレイクは、対照的なものより組織化とフィルタリングが少ない。
処理済みデータは、特定の用途に供された生データだ。データウェアハウスには処理済みデータのみが格納されるため、データウェアハウス内のすべてのデータは組織内で特定の目的で使用されている。これは、決して使用されないかもしれないデータでストレージスペースを浪費しないことを意味する。
アクセシビリティ
アクセシビリティと使いやすさは、データリポジトリ全体としての使用を指し、中身のデータではない。データレイクアーキテクチャは構造がないため、アクセスしやすく、変更しやすい。また、データレイクには制約がほぼないため、データへの変更を迅速に行える。
データウェアハウスは設計上より構造化されている。データウェアハウスアーキテクチャの大きなメリットは、データの処理と構造によりデータ自体を解読しやすくすることだが、構造の制約によりデータウェアハウスは操作が困難でコストがかかる。
両方のメリット
データレイクは多くのソースから大量データをコスト効率よく格納する方法だ。あらゆる構造のデータを許容することで、データが特定パターンに適合する必要がないためコスト削減になる。データはより柔軟でスケーラブルだ。一方、構造化データはクリーンで統一スキーマを持つため分析しやすい。データをスキーマに制限することで、データウェアハウスは特定データ決定のための履歴データ分析に非常に効率的だ。適切なデータウェアハウスとデータレイクの両方が、組織の将来成功に不可欠であり、モダンデータエステートに属する。
データエステートとは?
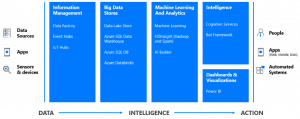
モダンデータエステートの確立は、デジタルトランスフォーメーションへの基盤的ステップだ。モダンデータエステートは、すべてのデータからタイムリーなインサイトと意思決定を可能にし、AIの基盤を築く。データエステートとは組織が所有するすべてのデータだ。このデータをクラウドに移行するか、オンプレミス環境をモダナイズすることで、イノベーションを促進する重要なインサイトを得られる。
Microsoft Dynamics 365事前構築データウェアハウス、DataCONNECT
データウェアハウス構築は、ソースシステムの適切なレビュー、データモデル設計、必要なETL処理の作成に非常に高コストと時間を要する。MCA Connectは、Microsoft Dynamics AX、Dynamics 365 Finance、Customer Engagement向けにDataCONNECTデータウェアハウスソリューションを開発した。このソリューションは包括的データウェアハウスソリューションの提供タイムラインを大幅に短縮し、導入コストを削減する。また、包括的データエステート構築の優れた出発点となる。
DataCONNECTは、高速で正確な情報で組織を強化し、予測、適応、精密な運営形成能力を与える。検証済みデータを予測モデルに迅速に取り込み、ビジネス領域の計画サイクルを開始できる。DataCONNECTデータウェアハウスやデータレイクでビッグデータ保存にどう役立てられるか知りたい場合はご連絡ください。専門家が適切な方向へご案内します。
この記事の内容と意見は著者のものであり、必ずしもManufacturing Tomorrowの見解を代表するものではありません。
産業技術
- クラウド×IoTの力を解き放つ:シームレスな接続とデータインサイトの実現
- 戦略的データソーシング:レジリエントなサプライチェーンの鍵
- 倉庫スキャンシステム効率を最大化するエキスパートのヒント
- 第4次産業革命:インダストリー4.0が製造業をどう再構築するか
- モノのインターネットにおけるデータコンプライアンスの確保
- 「信頼性のインターネット」におけるデータ活用:効果的管理のための戦略
- 予知保全:インダストリー4.0を活用した無停止生産の実現
- IoTの民主化:次世代衛星IoTがもたらす普遍的で手頃な接続性
- IoTデータの価値を引き出す:セキュアでインサイト主導の戦略
- アナログ測定がプラントパフォーマンスを向上させる理由
- 象牙からベークライトへ:現代プラスチックの進化をたどる