



ニューラルネットワーク訓練における局所的極小:神話か現実か?
パーセプトロンと多層ニューラルネットワーク訓練における局所的極小の役割を理解する
AACニューラルネットワークシリーズでは、多層パーセプトロン設計と訓練の多くの側面を検証してきました。局所的極小に入る前に、先行記事を復習:
- ニューラルネットワークを用いた分類の実行方法:パーセプトロンとは?
- シンプルなパーセプトロンニューラルネットワーク例を用いたデータ分類方法
- 基本パーセプトロンニューラルネットワークの訓練方法
- シンプルなニューラルネットワーク訓練の理解
- ニューラルネットワーク訓練理論入門
- ニューラルネットワークにおける学習率の理解
- 多層パーセプトロンによる高度な機械学習
- シグモイド活性化関数:多層パーセプトロンニューラルネットワークにおける活性化
- 多層パーセプトロンニューラルネットワークの訓練方法
- 多層パーセプトロンの訓練公式とバックプロパゲーションの理解
- Python実装のためのニューラルネットワークアーキテクチャ
- Pythonで多層パーセプトロンニューラルネットワークを作成する方法
- ニューラルネットワークを用いた信号処理:ニューラルネットワーク設計における検証
- ニューラルネットワークの訓練データセット:Pythonニューラルネットワークの訓練と検証方法
- ニューラルネットワークに必要な隠れ層と隠れノードの数
- 隠れ層ニューラルネットワークの精度向上方法
- ニューラルネットワークへのバイアスノード組み込み
- ニューラルネットワーク訓練における局所的極小の理解
ニューラルネットワーク訓練は洗練された最適化タスクです。効果的なモデル構築に全数学的ニュアンス理解は必須でないものの、局所的極小現象は重要な理論的考慮事項です。
局所的極小が重要な理由
歴史的に局所的極小は、特に複雑な入出力マッピングでは訓練の主要障害と見なされてきました。最近の研究(損失曲面幾何学研究、Choromanska et al., 2015; Dauphin et al., 2014)は、モダンアーキテクチャと訓練ヒューリスティックがこの問題の深刻度を軽減することを示唆。それでも局所的極小理解は、勾配ベースオプティマイザが高次元損失ランドスケープをどうナビゲートし、なぜ特定訓練戦略が準最適点から脱出できるかを理解する助けになります。
局所的極小の定義
単純な二次誤差曲面を考えます:f(x, y) = x² + y²。最低可能誤差を与える点—大域的極小—が訓練の目標。完全に凸なボウルでは、勾配降下法は開始位置に関わらず常にこの点に収束。
実践では損失曲面は凸から程遠く、複数の谷と台地を含みます(図示)。
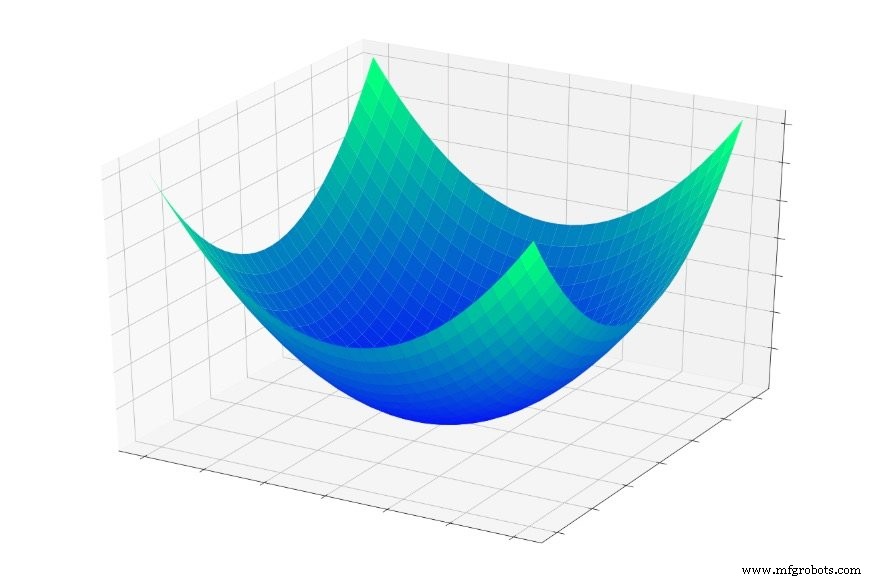
オプティマイザが浅い盆地に踏み込むと、その局所領域内で最低点である局所的極小に落ち着く可能性がありますが、大域的極小ではありません。大域的知識なしでは、アルゴリズムはより深い谷を探索するために「登り返す」ことができません。
真に大域的極小が必要か?
大域的極小到達は往々にして訓練誤差低減と相関しますが、必ずしもより良い汎化と同義ではありません。訓練データに完璧適合する高表現力ネットワークは過適合し、未知サンプル性能を低下させる可能性。そんな場合、適切に位置した局所的極小がよりロバストな解を提供し得ます。また、鞍点(勾配がいくつかの方向で消える平坦領域)が単純な局所的極小より大きな課題となり得ます(Goodfellow et al., 2015)。
実践的意義
現代訓練プラクティスは、確率的勾配降下法、学習率スケジュール、モメンタム、Adamオプティマイザ、重み初期化スキーム等で局所的極小影響を緩和。アンサンブル法と正則化(ドロップアウト、L2)もモデルが大域的極小に過適合するのを防助けます。
結論
局所的極小はニューラルネットワーク訓練の魅力的な側面であり続けます。その影響理解はアーキテクチャ、オプティマイザ、正則化戦略選択を導きます。次回記事では、学習率アニーリングや適応オプティマイザ等、ネットワークを望ましい極小へ導く具体的技法を探ります。
産業用ロボット
- ネットワークトポロジの理解:ポイントツーポイントからリングとスターまで
- ネットワークプロトコルの理解:物理層から高度なアービトレーションまで
- 人工ニューラルネットワークが無線通信性能を向上
- 大規模ニューラルネットワーク訓練のCO₂排出量は自動車5台分の生涯排出量に相当
- Pythonで多層パーセプトロンにバイアスノードを追加する
- 隠れ層サイズ最適化でニューラルネットワーク精度を向上
- ニューラルネットワークの隠れ層数とノード数選定ガイド
- ロボットファイバーレーザー切断 vs プラズマ切断:違いと最適な選択
- STMicroelectronics、STM32Cube.AI発表 – 組み込みニューラルネットワークでエッジデバイスを強化
- CEVA、エッジ深層ニューラルネット推論向け次世代AIプロセッサ「NeuPro-S」発表
- NISTのニューラルネットワーク、密集画像内の微小幾何学形状を97%精度で検出