



TensorFlowで変分オートエンコーダを構築:実践ガイド
オートエンコーダの基礎を習得し、変分オートエンコーダ(VAE)がどう拡張するか理解し、TensorFlowによるステップバイステップ実装を実践
人工知能は数え切れない分野を再構築し、データ圧縮も例外ではありません。オートエンコーダ、特にその変分変種は、効率的かつ表現力豊かな生成的圧縮スキームを提供します。本ガイドでは核心概念を分解し、MNISTデータセットを用いた完全なTensorFlow実装を歩みます。
オートエンコーダの応用
オートエンコーダは、ニューラル機械翻訳から創薬、画像デノイジング、異常検知まで幅広い分野で採用されています。圧縮された情報豊かな表現を学習する能力が、現代MLパイプラインの定番ツールとなっています。
オートエンコーダの主要コンポーネント
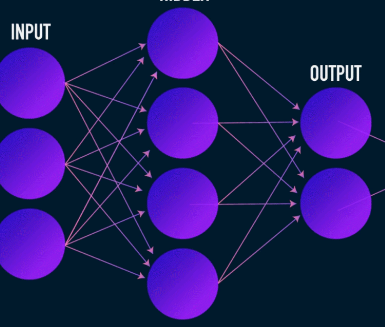
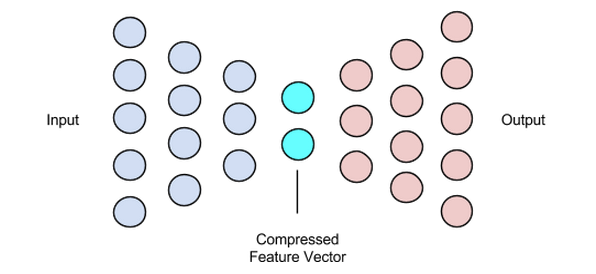
典型的なニューラルネットワークと異なり、オートエンコーダは低次元潜在表現を強制するボトルネックを備えます。アーキテクチャは3主要部分で構成:
- エンコーダ – 入力データを潜在ベクトルに圧縮
- ボトルネック(潜在ベクトル) – 最も顕著な特徴を格納
- デコーダ – 潜在ベクトルから入力を再構築
エンコーダとデコーダは通常フィードフォワードネットワークですが、実践では画像用CNN、テキスト用RNN等の特殊変種が一般的。
エンコーダ
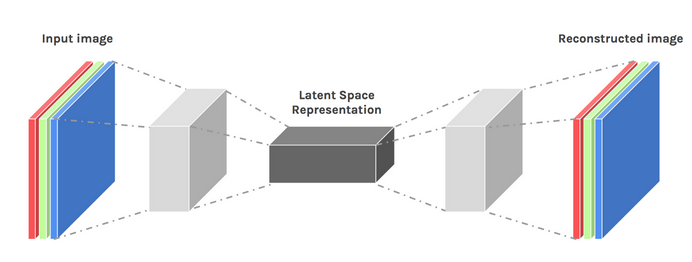
エンコーダは高次元入力(例:28×28ピクセル画像)をコンパクトな潜在ベクトルにマッピング。訓練中、潜在ベクトルが本質的情報を捉え、デコーダが最小損失で入力を再構築できるよう重みを最適化。
ボトルネック(潜在ベクトル)
潜在ベクトルサイズはトレードオフ:小さすぎると重要詳細を失い、大きすぎると圧縮を損ない計算コスト増大。適切な次元選択がモデル性能に不可欠。
デコーダ
デコーダはエンコーダの鏡像で、潜在ベクトルを元のデータ空間に戻す変換。通常、転置畳み込みやアップサンプリング層で空間解像度を回復。
オートエンコーダの訓練
オートエンコーダはAdam等の勾配ベースオプティマイザでエンドツーエンド訓練。目的は入力とその再構築の乖離を定量化する再構築損失を最小化すること。
損失関数
一般的選択肢:L1、L2、平均二乗誤差(MSE)。各々出力が入力にどれだけ近いか測定し、生成的再構築タスクに適する。
ネットワーク変種
多層パーセプトロン(MLP)もエンコーダ/デコーダとして機能可能だが、画像データには空間認識を持つCNNが好まれる。再帰ネットワークはテキスト等シーケンシャルデータで優れる。
標準オートエンコーダには創造性がない—訓練中に見たデータのみ再生可能。変分フレームワークで確率性を導入することで生成能力を解放。
変分オートエンコーダ(VAE)
VAEは標準アーキテクチャを2点で修正:
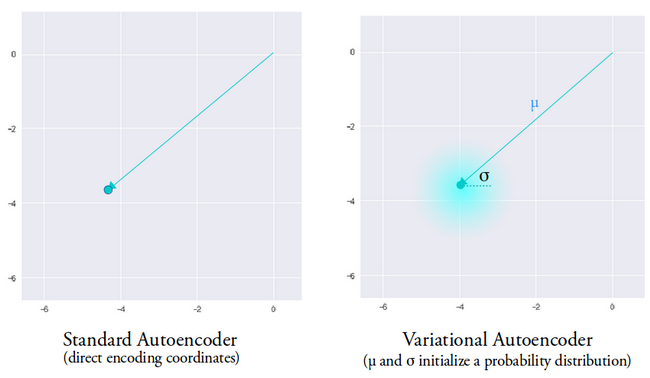
- エンコーダが平均ベクトルと分散ベクトルを出力し、ガウス分布を定義
- Kullback-Leibler(KL)ダイバージェンス項を損失に追加し、潜在分布を単位ガウスに正則化
推論時、エンコーダが学習分布から潜在ベクトルをサンプリングし、デコーダが多様で現実的な再構築を生成可能に。この確率性が決定論的オートエンコーダで観測される不連続性を緩和。
TensorFlow実装
以下はMNISTで訓練された畳み込みVAEの簡潔で本番対応可能なTensorFlow実装。
データ準備
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
VAEモデル定義
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])
    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)
    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar
    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean
    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
キーとなるヘルパー関数—encode、reparameterize、decode—がVAEワークフローをカプセル化。reparameterizeメソッドは再パラメータ化トリックを実装し、確率的サンプリングを通じた勾配流を可能に。
再パラメータ化トリック
分布から直接潜在ベクトルをサンプリングすると微分可能性が破綻。サンプルをz = mean + std * eps(eps ~ N(0,1))と表現することで、勾配がmeanとstdを通過可能に。KLダイバージェンス項が学習分布を標準正規分布に整列させ、滑らかな潜在空間を促進。
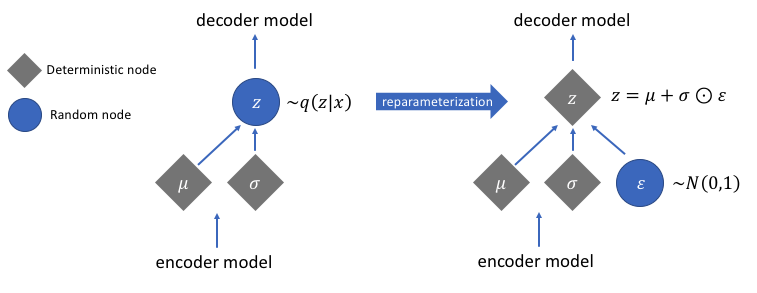
ステップ要約
- エンコーダとデコーダアーキテクチャを定義
- 再パラメータ化トリック実装でバックプロパゲーション可能に
- モデルをエンドツーエンド訓練、再構築損失+KLダイバージェンスを最小化
完全なコードと追加訓練スクリプトはTensorFlow公式チュートリアル参照。
画像クレジット:Chiman Kwan(改変)
産業用ロボット
- AI駆動ロードマップ:サプライチェーン企業のための戦略的ガイド
- データマイニングとAIを活用し、産業ブランドがECで成功するためのブループリント
- 機械データで工具寿命を最適化:モダンガイド
- 自律ロボットで廃棄物とエネルギーコストを削減
- コボットでCNC工作機械の機械監視を自動化:効率と精度を向上
- 3Dプリンターが金属パーツを製造する仕組み:粉末から精密部品へ
- クラウドテクノロジーの保護:データ保護とリスク軽減のベストプラクティス
- 「信頼性のインターネット」におけるデータ活用:効果的管理のための戦略
- IoTでHVACビッグデータを活用:エネルギー、快適性、空気質の最適化──第2部
- IBMとTech DataでIoTを現実に - パート2
- IoTを現実に:Tech DataとIBMの洞察 - パート1