



クラウド障害の理解:原因、影響、対策を徹底解説
ITがクラウドサービスに依存すればするほど、クラウド障害によるダウンタイムと収益損失のリスクは高まります。パブリッククラウドを利用する組織の60%以上が2022年にこれらのインシデントにより損失を報告しており、障害は「企業が滅多に直面しない珍しい出来事」ではありません。
しかし、障害はクラウドを完全に放棄する十分な理由になるのでしょうか? それとも、時折発生するダウンタイムのリスクを許容してでも、このインフラタイプを継続すべきでしょうか?
本記事では、クラウド障害について知っておくべきすべてを網羅します。主な原因を整理し、目を開かせる統計を検証し、クラウドダウンタイムの影響を最小化する方法を示し、近年発生した最もインパクトの大きい障害事例を振り返ります。
クラウド障害とは
クラウド障害とは、クラウドプロバイダーのサービスがエンドユーザーにとって利用不能になる期間を指します。ベンダーのインフラがダウン(バグ、電力障害等により)し、プロバイダーが問題を修正するまで、クライアントはクラウドベースの資産にアクセスできなくなります。
インパクトの観点では、オンプレミスデータセンターのダウンとクラウド障害に違いはありません。どちらもIT資産へのアクセスを失います。しかし、クラウドコンピューティングの「ハンズオフ(運用を委託)」アプローチには、いくつか独自の考慮点が加わります。
- クラウド障害では障害の可視性がほぼゼロであり、ユーザーは通常「何が起きたか」を知ることができない
- 問題の修正責任はプロバイダーチームにあり、クライアントは復旧プロセスに関与できない
- 可視性も制御もないため、サービスがいつ復旧するかを知る術がない
オンプレミスハードウェアと同様、クラウド障害には2種類あります。
- 計画的(通常はスケジュールメンテナンスによる)
- 非計画的(プロバイダーが予期せぬエラーに遭遇し、復旧措置を実施せざるを得ない場合)
最近の調査によれば、非計画的障害は計画的ダウンタイム(オンプレミス・クラウド問わず)より35%コストが高いとされています。この価格差は、予期せぬインシデントの方が特定と修正に時間を要するためであり、障害が長引けば被害も大きくなるからです。
オンプレミスハードウェアと比較すると、クラウドベースのインフラは「より頻繁なダウンタイムだが、深刻度は低い」傾向にあります。どのホスティングシステムも100%の稼働率を保証することはできないため、クライアントはクラウドコンピューティングの利点と引き換えに、時折の障害を許容する姿勢です。この姿勢は市場成長にも表れています。クラウドは2024年に世界総IT支出の14.2%を占めると予測されています(2020年は9.1%)。
クラウド障害の原因
クラウド障害は、プロバイダーの制御内外を問わず、さまざまな原因で発生します。主なものをリストアップします。
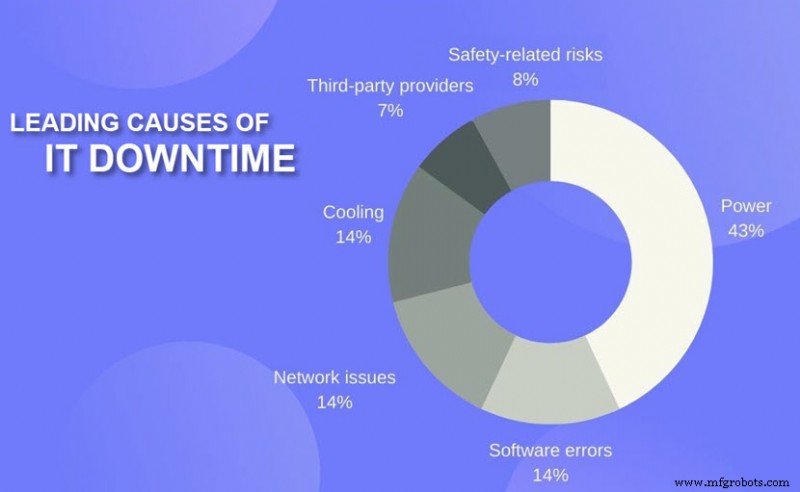
- 電力障害:電力関連の問題が、大幅なダウンタイムと財務損失を伴うクラウド障害の43%を占める。無停電電源装置(UPS)の故障が電力インシデントの第一要因
- サイバーセキュリティ:DDoS(分散型サービス妨害)攻撃がデータセンターに大量の着信トラフィックを押し寄せ、エンドユーザーが同一ネットワークインフラ経由でサービスにアクセスできなくなる。ランサムウェアやSQLインジェクション等の他の脅威では、プロバイダーがサービスを停止してオフラインで対処せざるを得なくなる場合も
- 人為的ミス:単一の誤ったコマンドやケーブル接続ミスが、ITインフラ全体をダウンさせる。人為的ミスは物理的・ソフトウェア的の両面で障害を引き起こす
- 技術的問題:クラウドサービスは複雑なハードウェア技術システムに依存しているため、長期間検知されないエラーが障害を招くことがある
- ソフトウェアバグ:クラウドデータセンターではグリッチとバグが常態化。典型的な原因はデータ形式バグ、障害関連バグ、タイミングバグ、定数バグ
- ネットワーク問題:ネットワーク通信およびサードパーティ通信事業者パートナーに関連する問題も、障害の一般的な原因
- メンテナンス:計画メンテナンスとシステムアップグレードが障害を招くこともあるが、エンドユーザーは通常これらを事前に通知される
- 環境要因:ハリケーン、火災、落雷、地震等のイベントも、施設を危険にさらしたり、地域の電力網を損傷させたりすることでクラウドダウンタイムを引き起こす
- より複雑なデプロイメント:ハイブリッド、分散、マルチクラウド等の複雑なデプロイメントモデルは、データセンター運用を複雑化し、エラーの機会を増やす
クラウドがダウンするとどうなるか
ベストケースでは、障害は数分間のみ継続し、少数のユーザーまたはサービスにのみ影響します。ワーストケースでは、障害が半日以上にわたりクライアントのビジネスを麻痺させます。企業はすべてのクラウドベース資産へのアクセスを失い、障害が終了するまで隔絶されます。
脅威的ではありますが、サードパーティプロバイダーのミスが「重大な障害」の原因となったのは2021年に「わずか7%」でした。重大な障害には、以下のいずれか(または複数)が伴う必要があります。
- 多額の財務損失
- レピュテーション毀損
- コンプライアンス違反
- 人命の損失
より差し迫った懸念がある(以下のドーナツチャート参照)ものの、ダウンタイムの平均的な1分あたりのコストは5,600ドル(エンタープライズでは9,000ドル)であることを忘れないでください。準備不足(データバックアップなし、災害復旧なし等)の場合、クラウド障害はサービスを完全停止させ、収益に甚大な打撃を与える可能性があります。
業務のごく一部のみをクラウドで運用している企業は、障害の影響を受けにくいです。例えば、メールのみをクラウドでホストしている場合、1日間の障害でも壊滅的ではありません。インシデントをやり過ごすか、機能を制限してアプリを稼働させる戦略が取れます。しかし、IoTプラットフォームの運用や決済処理にクラウドを使用している場合、この戦略は通用しません。
ケースによっては、クラウド障害が永続的なデータ損失を招きます(損失量はバックアップ頻度に依存)。また、厳格な規制業界のクライアントは、障害がデータ侵害や漏洩につながった場合、法的罰則の対象となるため、クラウドストレージに何を保管するかは慎重に判断すべきです。
ユーザー側でできる対策
企業がクラウド障害の影響を軽減するために講じている対策を紹介します。
- 単一障害点(SPOF)の排除:ミッションクリティカルなITコンポーネントすべてのバックアップを、オンプレミスサーバールームまたはセカンダリプロバイダーに用意。クラウドがダウンしたら、フェイルオーバー(スタンバイサーバー、ハードウェアコンポーネント、ネットワーク等への切り替えプロセス)を実行し、ビジネス継続性を確保
- コンティンジェンシープラン(緊急時対応計画)の策定:災害復旧計画は、障害発生時のチームの行動をステップバイステップで定義。データ保護、フェイルオーバー実行、ビジネス継続性確保、運用復旧の手順を規定。クラウド障害への事前計画により、ダウンタイム中に最善の対応を検討する時間を浪費しない
- より高い可用性SLAへの投資:ビジネスクリティカルなタスクが長時間のクラウド障害を許容できない場合、99.999%稼働(年間最大ダウンタイム5.25分)を保証するような、より高い可用性のサービスレベル契約(SLA)を検討。これらの契約は高額だが、サービスをオンラインに保つことがプロバイダーにとってより高い優先度になる
- 定期的なデータバックアップの実施:バックアップがあれば、クラウド障害でデータベースが破損・削除された際、チームは直近のバージョンを復元可能。理想的にはバックアップは自動で、ミッションクリティカル度に応じて1時間〜1日おきに実施
- 障害をいち早く検知:チームが独自に追加でセットアップするクラウド監視機能は、プロバイダーの通知を待つ代わりに、リアルタイムで障害を特定するのに役立つ。ダウンタイム検知を改善し、タイムリーなフェイルオーバーを確保するためのベストクラウド監視ツールを紹介
近年の主要なクラウド障害事例
クラウド障害はクラウド利用の宿命であり、Azure、AWS、Google Cloudのような最大手プロバイダーでさえ免疫を持たないことを、最近の事例が示しています。近年の最も重大なクラウド障害をいくつか振り返ります。
Azure障害(2021年10月)
2021年10月、Microsoft Azureで障害が発生し、仮想マシンサービスが6時間ダウンしました。障害期間中、多くのユーザーが新しいVMのデプロイや拡張機能の更新が不能になり、基本的なサービス管理操作(開始、作成、削除)もエラーを返しました。
原因は、VMクエリがアーティファクトの必要なバージョンデータを取得できなかったこと。事後報告書によると、ソフトウェアベースのミスは、MicrosoftがVMアーキテクチャの一つを移行した際に発生しました。
Google Cloud障害(2021年11月)
2021年11月中旬、Google Cloudが約2時間ダウンし、以下のような大手サービスに影響を与えました。
- Home Depot
- Snapchat
- Etsy
- Discord
- Spotify
影響を受けたWebサイトは、訪問者がアクセスしようとすると404エラーを表示しました。Googleは、負荷分散を担当するネットワーク設定のグリッチが原因と報告しています。
AWS障害(2021年12月)
AWSの旗艦施設の一つで、大量の接続アクティビティ急増がネットワークデバイスを圧倒し、さまざまなWebサイトとアプリに影響を与えました。最も著名な「被害者」には以下が含まれます。
- AmazonのWebサイト
- Prime Video
- Netflix
- IMDb
- PlayStation Network
データセンターの問題により、内部AWSネットワーク内で深刻なレイテンシが発生。顧客アプリは波及効果を受け、約7時間にわたりトラフィック遅延や完全停止に見舞われました。
IBMの連続障害(2022年1月)
IBMのインフラ問題により、ダラスリージョンのクラウドサービスが5時間以上影響を受けました。社内チームが問題を解決したものの、誤って仮想プライベートクラウドに追加の1時間の問題を発生させました。二次的な問題は、米国、日本、カナダ、ドイツを含む世界中のユーザーに影響を与えました。
AWS/Slack障害(2022年2月)
2022年2月、SlackがAWSクラウドリソースの障害を受け、コミュニケーションプラットフォームの正常な利用が5時間不能になりました。11,000人以上の報告ユーザーが以下の操作不能に陥りました。
- メッセージの送受信
- ファイルのアップロード
- チャンネルへの参加
- デスクトップアプリの起動
Slackチームは障害の理由を公表せず、復旧後にすべての影響ユーザーにアプリの再起動とキャッシュクリアを要請しました。
iCloud障害(2022年3月)
2022年3月、Appleの主要15サービスがクラウド障害により4時間ダウンしました。影響を受けたサービスには以下が含まれます。
- App Store
- Apple Maps
- Apple TV
Appleの企業システムと小売システムもダウンしました。後日、根本原因はドメインネームシステム(DNS)関連の問題だったと明らかにされました。
Google Cloud障害(2022年3月)
2022年3月8日、Google Cloudユーザーが2時間半サービスエラーを経験しました。SpotifyとDiscordが影響を受けました。
設定処理を担当するTraffic Directorコードの変更がエラーの原因でした。事後報告書によると、不適切なコード変更が設定データ形式の移行を怠ったため、プラットフォームがユーザーのプログラミングを誤って削除してしまいました。
Atlassian障害(2022年4月)
2022年最大のAtlassian障害は4月5日に始まり、4月18日に終了(一部ユーザーは4月8日からサービス復旧開始)。同社は、不十分なチームコミュニケーションと不適切なインシデント対応計画が原因と説明しました。
このクラウド障害は一部ユーザーにとってほぼ2週間継続しましたが、クライアントデータの重大な損失報告はありませんでした。しかし、TrelloとJiraという両旗艦製品のユーザーが影響を受けました。
Microsoft Azure障害(2022年6月)
2022年6月7日、Azure顧客がEast US 2リージョン(主にバージニア州)でホストされるリソースに接続不能になりました。障害は約12時間継続し、ゾーン冗長インフラを利用するコンシューマーには影響しませんでした。影響を受けたサービスには以下が含まれます。
- Application Insights
- Log Analytics
- Managed Identity Service
- Media Services
- NetApp Files
原因は、ローカルデータセンターの一つで発生した突然の電力変動により、空調ユニット(AHU)が停止したことでした。
Cloudflare障害(2022年6月)
2022年6月、Cloudflareでの偶発的な障害により、1時間半の大規模な混乱が発生し、以下のような人気サイトがダウンしました。
- Discord
- Shopify
- Fitbit
- Peloton
サンフランシスコ拠点のベンダーは、19のデータセンターでのネットワーク設定変更が非計画的ダウンタイムの原因と説明しました。
クラウド障害対策の重要性を見逃さない
近年のクラウド障害事例は明確なメッセージを送っています:クラウドはITのゲームチェンジャーだが、万能ではない。エンドユーザーとアプリの可用性を重視する企業は、時折のダウンタイムに備える必要があり、それがバックアップと災害復旧(BDR)をクラウドベースリソース利用の不可欠な要素にしています。
クラウドコンピューティング
- トランスファーモールディングを徹底解説:プロセス、メリット、バリエーション
- 車のトランスミッション完全解説:種類、機能、動作原理
- 真空システム監査の完全ガイド:重要性、実施手順、コスト削減効果
- 産業用クラッチの理解:定義、機能、用途
- クレーン検査プロトコル:実施時期・重要性・ベストプラクティス
- パブリッククラウドパフォーマンスのベンチマーク:なぜ重要か、どう行うか
- クラウドセキュリティ理解:なぜあなたのビジネスに必要か
- クラウド革命:IT、セキュリティ、キャリアをどう変えるか
- エージェントレス vs エージェントベース:最適なクラウドセキュリティモデルの選び方
- 難読化VPNサーバーの理解:仕組みと重要性
- Google Cloud Storageの仕組み:完全ガイド