



AIをスケールさせて実ビジネス成果を:運用成功のための実証済み戦略
人工知能(AI)は、業界を問わずビジネスの「ニューノーマル」を駆動しています。小売業者は、例えば、過去の在庫データに基づいて発注を予測し、インテリジェントな補充決定を下すためにAIを活用できます。カスタマーサポートチームは、AIを用いて優先度の高いチケットに自動応答し、適切なチームにルーティングできます。AI、特にML(機械学習)を用いて実践的なビジネス成果を導き出せる可能性は無限に広がっています。
Deloitte Insightsによると、エンタープライズAIのアーリーアダプターの83%が、本番環境のプロジェクトからプラスのROI(投資対効果)を得ています。これには、AIを活用したサードパーティエンタープライズソフトウェアの導入、チャットボット・バーチャルアシスタントの活用、Eコマースプラットフォーム向けレコメンデーションエンジンなどが含まれます。調査対象企業の83%が2019年にAI支出を増やす計画でした。AIに投資している企業のうち、63%がMLを導入済みでした。
ビジネス目標を達成するためにAIとMLを実践的に活用する戦略を構築することは、多くの企業にとって最優先事項です。多くの企業にとって、MLを成功裏に運用化する上での主な課題は、組織全体での包括的なML導入を、いかに理解、計画、実行、管理するかです。
ML運用化のトップ考慮事項
データサイエンスライフサイクルの「正しい」取り組み方は、組織によって異なります。データサイエンスライフサイクル手順を成文化・標準化する試みは数多くありました。しかし、あらゆる企業のニーズを取り込んだアプローチは存在しません。
データとデータサイエンスのための持続可能で保守可能な戦略を受け入れることは、各企業固有の、常に進化し続ける営みです。すべての企業のニーズ、構造、能力がユニークであるため、企業全体のステークホルダーを巻き込み、柔軟でスケーラブルなMLモデルを構築し、包括的なデータサイエンス戦略を実行する必要があります。
各企業が対処しなければならない運用上の課題と、インフラ・開発プラクティスの変更は異なります。
貴社の文化、システム、ニーズを考慮に入れながら、データサイエンスライフサイクルを定義・進化させることが極めて重要です。チーム横断で共通のコミュニケーション基盤を築くためのベースフレームワークを持つことは、MLの運用化を継続的に発展・進化させる上で役立ちます。
組織のMLジャーニーを始めるのに役立つ標準フレームワークを歩いてみましょう。
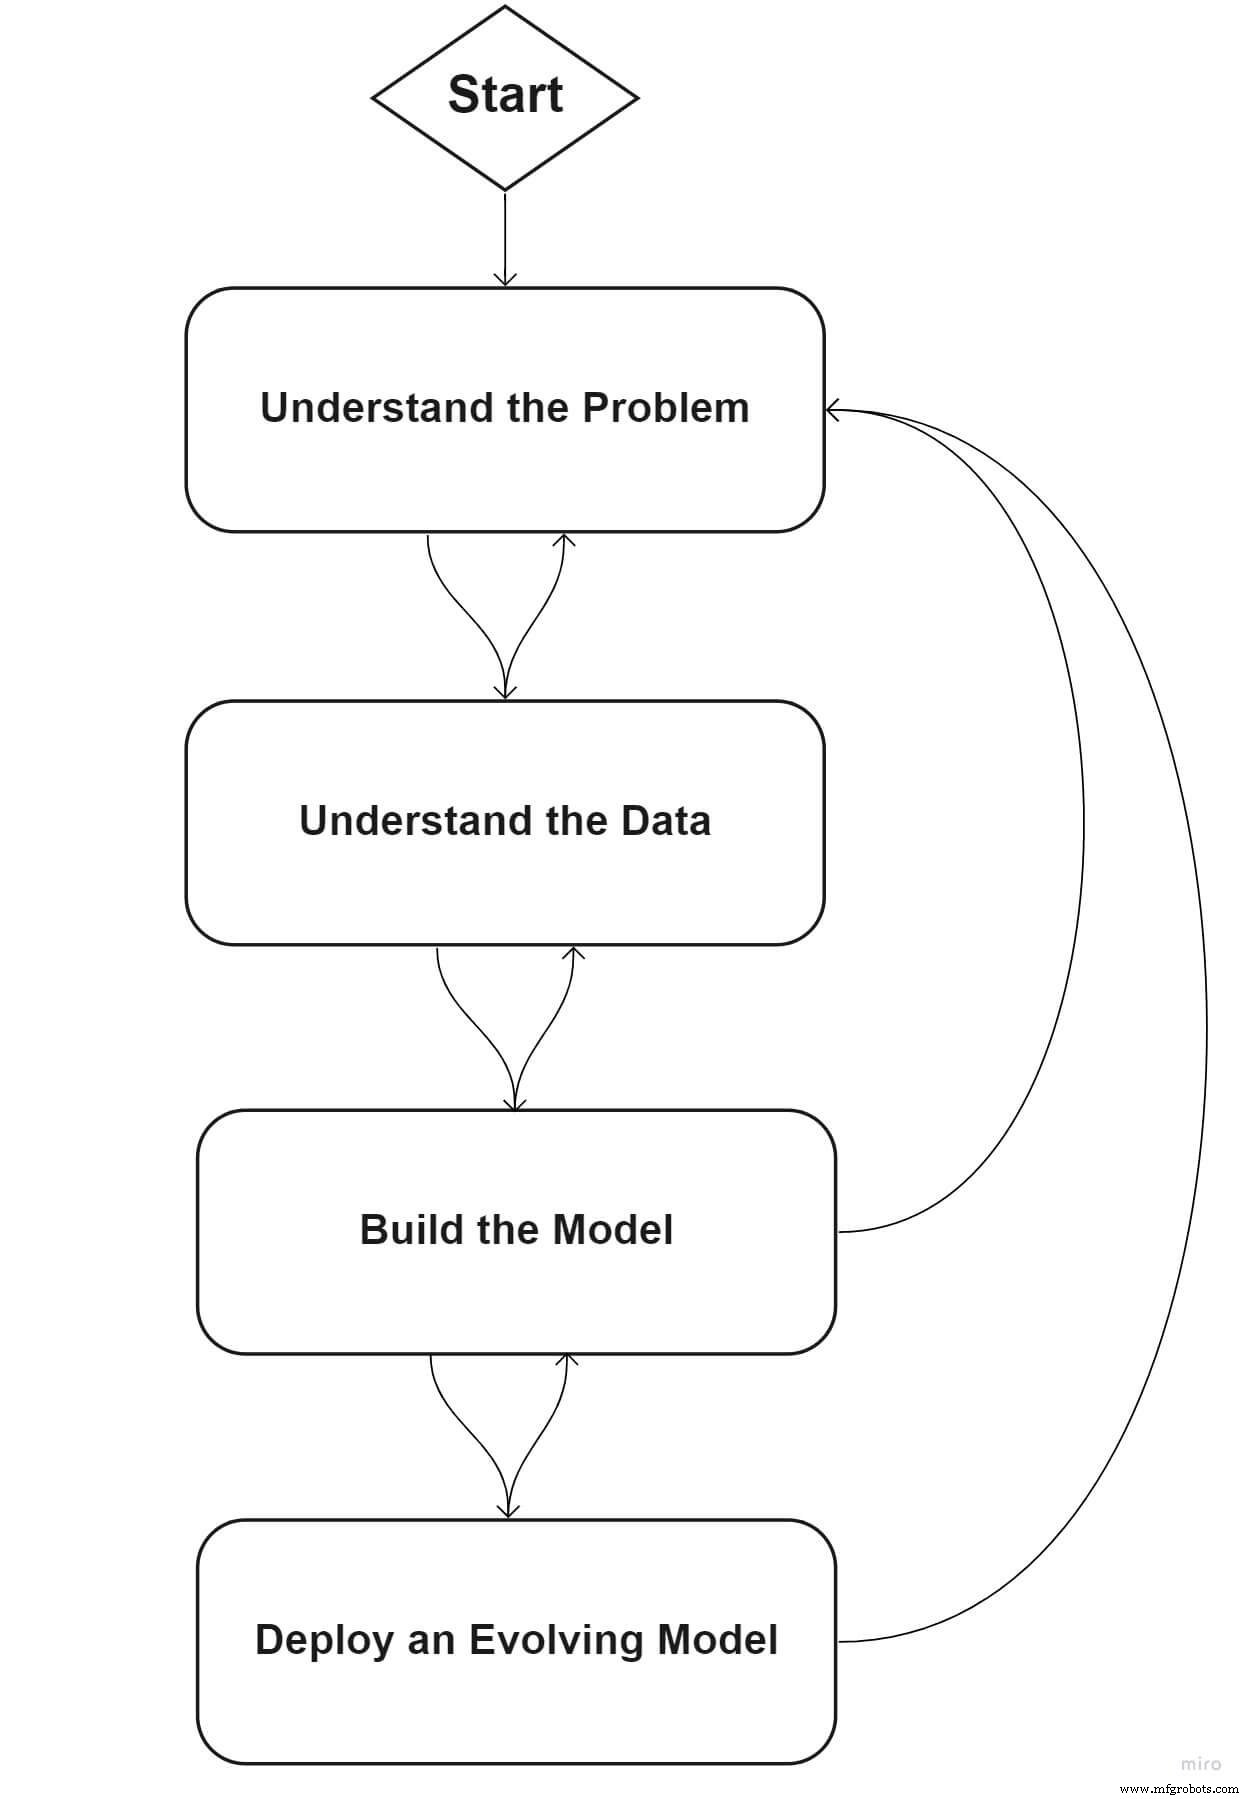
フェーズ1:問題を定義する
あらゆるMLイニシアチブの核心には2つの質問があります:
1. 何の問題を解決しようとしているか?
2. なぜMLとデータのより深い理解が、手元の問題解決に役立つと信じるのか?
これらの答えは、貴社が戦略についてどう考え、ビジネス問題をどう評価するかに依存します。
フェーズ1では、主要ステークホルダーが集まり、問題の初期スコープと要件を定義すべきです。
フェーズ2:データを理解する
データのストーリーは何か?データはどこから来て、特定のビジネス問題解決に関連するデータソースはいくつあるか?
このフェーズでは、企業は以下に焦点を当てます:
関連データソースとそれらが存在する環境(オンプレミス、クラウド、データウェアハウス、データレイク、ストリーミングデータプラットフォームなど)をマッピング
現在存在するデータパイプラインと、データ検証・クリーンアップ・探索のために構築すべきパイプラインを定義
データ更新頻度を理解
データの信頼性を理解
データプライバシーの考慮事項と要件を評価
可視化、生データ・変換済みデータの統計的特性などを通じたデータ探索を可能にする
データを理解するのは小さな仕事ではありません。このフェーズを反復的に進めることが重要です。データについてより多く発見するにつれ、問題解決能力に影響する問題が発見され、フェーズ1で問題を再定義・リスコープする必要が生じるかもしれません。
フェーズ3:MLモデルを構築する
データの準備ができたら、データサイエンティストがMLモデルを構築する番です。堅牢なMLモデルを構築する一般的なステップには以下が含まれます:
特徴量の抽出とエンジニアリング(ビニング、データホワイトニング、統計的変換の適用を含む)
特徴量選択
モデル訓練(データを任意の数の訓練、交差検証、検証データセットに分割することを含む)
ハイパーパラメータチューニング
モデル評価
統計的有意性の検証
モデル開発には、ビジネスステークホルダーからの継続的なフィードバックが必要です。例えば、ビジネス問題が感度と特異度への親和性を求めるかもしれません。わずかな予測性能(F1スコアなど)を犠牲にして、モデル運用性能(高速予測など)やモデル説明性を得るトレードオフもあり得ます。
データサイエンティストの目標は、データを用いてビジネス問題に関連する明確なストーリーを語るモデルを構築することです。問題が進化し要件が変われば、モデリングアプローチも現在の文脈に奉仕するよう進化しなければなりません。
フェーズ4:進化するモデルを展開する
初期モデルの構築は、MLジャーニーの始まりに過ぎません。進化するモデルを展開することは、組織の長期的価値創造に向けた重要なステップです。
進化するモデルの展開には以下が必要です:
モデルのサービング(モデルを高可用性かつ水平スケーラブルにする)
モデルバージョン管理(ロールバック、カナリア/チャレンジャー展開を含む)
モデルの再訓練(新しいデータがシステムに入ってくるにつれ、モデルを修正または新規構築)
モデル監視(サービング時と訓練時の両方で、運用指標とユーザー体験指標を追跡)
データとモデルのドリフト監視、社内特定ユースケース向けのモデル特化、データパイプラインの維持(その他の維持管理項目含む)は、モデルの継続的成功に不可欠です。
全社的・業界的な要件は急速に進化し、データソースと入力に影響を与えます。例えば、大規模なガバナンスとコンプライアンスは、データサイエンスライフサイクル全体にわたる考慮事項です。
EU一般データ保護規則(GDPR)などの規制コンプライアンスは、データバージョニング、モデルバージョニング、モデル入力レイヤーでのより深いトレーサビリティを要求します。データを通じてこれらの業界変化と要件に対応する戦略を構築すれば、企業はMLを活用し続け、収益成長、コスト削減、リスク低減といったより良いビジネス成果を導き出せます。
次に向けて
柔軟で保守可能、スケーラブルな方法でMLを運用化するには、このブログで概説したハイレベルなスコープを超える多くのステップと考慮事項が必要です。詳細は細部に宿ります。
次のブログでは、技術的考慮事項、大規模MLシステムのアドホック実装から生じる課題、UiPathがエンタープライズ顧客の一般的な課題をどう解決するかを深掘りします。
自動制御システム
- ボッシュ、ハノーバーメッセでAI駆動製造ソリューションを発表
- AI駆動テスト自動化:最新ERPシステムのQAを革新
- ビジネス インテリジェンス (BI) 入門:組織にとっての重要性
- AI駆動ロボティクス:最先端インテリジェントマシン
- ビジネスインテリジェンスの習得:データ駆動型成功のための勝利戦略の策定
- AI:メリット、リスク、産業への影響
- ビッグデータとAI:デジタルトランスフォーメーションを支える相乗効果
- 小売におけるAI:一過性の流行ではなく実証済みのメリット
- AIがIoT革命を加速する仕組み
- AIがIoTの力をどう増幅するか:人工知能とモノのインターネットの融合
- 産業AIoT:AIとIoTの融合でインダストリー4.0イノベーションを推進